這篇在講什麼
我現在手上常用兩個模型:Anthropic 的 Claude Opus 5.5,和 OpenAI 最便宜的那一級 Luna。我給它們的分工很簡單,Opus 5.5 負責動腦,Luna 負責搬磚。
這篇把我實際交給它們的工作列出來,也講 Luna 交過白卷的那一次,最後整理成三個問題,幫你判斷一件工作該交給貴的還是便宜的模型。
・你心裡有這個問題:「頂規模型很貴,怎麼把複雜的交給它、其他交給便宜的?」
・你做了一個 AI 小工具要每天跑,或想開放給朋友用,怕月費失控
・你幫客戶導入 AI,需要一套講得清楚的模型分工給對方
・我目前的分工表:哪些工作給 Opus 5.5,哪些給 Luna
・判斷一件工作該交給哪一邊的三個問題
・便宜模型上線前的一道考試,以及一段可以直接貼給 AI 的分工提示詞
我的模型分法:Opus 5.5 動腦,Luna 搬磚
先說明兩個名字。Opus 5.5 是 Anthropic 在 2026 年 9 月 22 日推出的 Claude 模型。Luna 是 OpenAI 模型的等級名,同一代分三級:Sol 最貴,Terra 中間,Luna 最便宜。GPT-5.6 和 GPT-6 都有 Luna,下面每個例子都標出實際用的是哪一代。同一個模型還可以調推理強度,也就是讓它想久一點或快一點,下面會看到低推理、中推理、高推理。
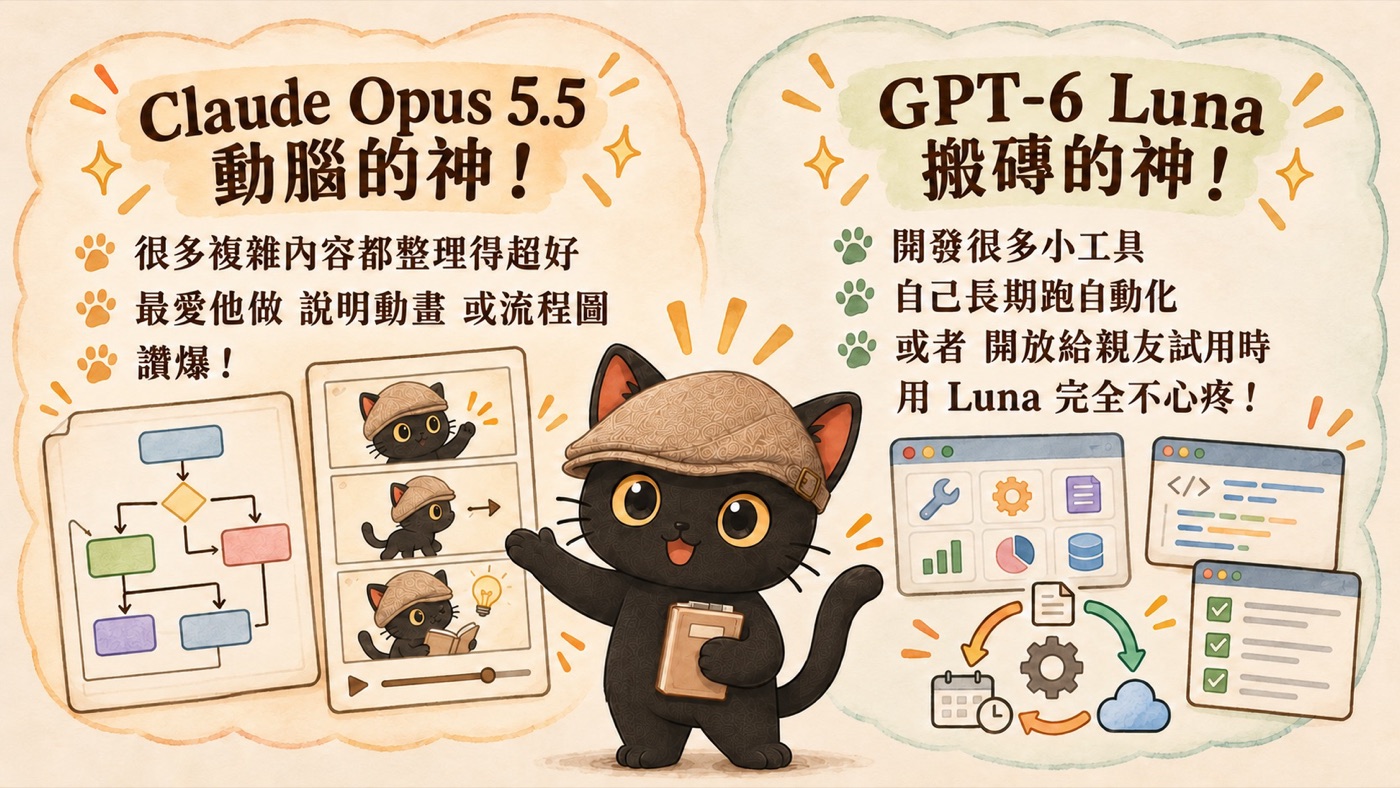
我畫成一張圖(就是這篇的封面),上面寫的是我自己的感受:
- Claude Opus 5.5,動腦的神。很多複雜內容都整理得超好,最愛它做說明動畫或流程圖。
- GPT-6 Luna,搬磚的神。開發很多小工具、自己長期跑自動化,或者開放給親友試用時,用 Luna 完全不心疼。
這是我現在的分法。兩家各有擅長的地方,換一個工作場景,分工可能就會不同。
交給 Opus 的工作:整理複雜內容、做說明動畫和流程圖
| 工作 | 實際例子 |
|---|---|
| 清理會議逐字稿 | 洽談、合約討論的逐字稿動輒上萬字,交給 Opus 子代理清理,附一份語音辨識錯字對照表當校正依據 |
| 講座課後整理 | 一場「AI 做網站」免費講座的逐字稿,整理成 19 章的教學手冊 |
| 內部會議記錄 | 照會議記錄技能包的格式,整理成內部會議記錄 |
| 說明動畫 | 咪卡陪講的講解動畫,一支約 20 秒,我也發過脆文分享 Opus 5.5 生成的咪卡動畫;做順了之後固定成技能包 |
| 流程圖、輔助決策頁 | 要拍板之前的對照頁、流程圖 |
同類的工作會一再出現,但每一件都要先讀懂很多內容,再重新組織成別人看得懂的樣子。
我最愛它做的是說明動畫和流程圖。
- 什麼叫子代理?從分頭查資料到 30 人工作坊頁面 上面說的「子代理」是什麼、怎麼叫它分頭做事,看這篇。
- AI 回答太長看不下去?把內容變成白話、流程圖與說明網頁 流程圖和說明網頁怎麼請 AI 做,那篇有步驟。
- 會議有錄音也有逐字稿,為什麼事後還是查不到重點?|我的會議記錄 Agent 工作流 逐字稿清理之後怎麼變成查得到的會議記錄。
交給 Luna 的工作:小工具、長期自動化、開放給親友試用
| 工作 | 實際例子 |
|---|---|
| 官網 AI 客服 | 知識官網上公開的咪卡客服,預設用 GPT-5.6 Luna |
| LINE 群助理 | 萊卡在 LINE 群回話,預設用 GPT-5.6 Luna,複雜的題目才換更大的模型 |
| 給合作單位的 AI 秘書 | 給旅學堂用的旅貓秘書,只讀資料不寫入,用 GPT-5.6 Luna 開高推理 |
| 每天自動整理群組訊息 | 幫一個扶輪社做的活動看板,每天晚上八點自動整理一次,用 GPT-6 Luna 中推理 |
這些工作的共同點是有人用就要呼叫一次模型,用的人越多、跑得越久,次數累積得越快。單次便宜,累積起來才看得出差別。
兩個算過的帳:
- 官網文字客服:目前用 GPT-5.6 Luna。以每月 3000 則、每則約 2000 token 輸入、300 token 輸出試算(token 可以想成模型計費用的字數單位),Luna 約 2.28 美金,同樣的量用 Google 的 Gemini Flash-Lite 約 4.05 美金。照這組試算,文字客服用 Luna 比較便宜。
- 扶輪社活動看板:GPT-6 Luna 單次呼叫約 0.01 美金,GPT-6 Sol 單次約 0.17 美金。正式做法是每天同時呼叫 Luna 兩次互相比對,不一致才再叫 Sol。加上把整理頻率從每三小時改成每天一次,月費從約 14 美金估到 0.2 到 0.4 美金。
開放給親友試用的時候,用 Luna 完全不心疼。
便宜模型也會交白卷:Luna 上線前先考一次
Luna 也有沒做好的時候。
扶輪社活動看板第一次試 Luna(當時是 GPT-5.6),推理強度開最低,讀完 138 則訊息,交出一份空的結果,等於交白卷。後來出一份固定考卷重新考:
| 模型 | 分數(滿分 36) | 狀況 |
|---|---|---|
| GPT-6 Sol 低推理 | 34 | 只考一次 |
| GPT-6 Luna 中推理 | 32 到 34 | 考六次,分數穩定 |
| GPT-6 Luna 低推理 | 22、36、26 | 會漏抓整場活動,機械檢查抓不到 |
所以現在的做法是:Luna 開中推理,同時跑兩次互相比對,兩次結果不一致才改叫 Sol。
- AI 小工具該用便宜模型還是貴的?|同一份考卷考三輪,新模型出來就重新評估 這裡只放結果,那篇有三輪各自怎麼考、考卷怎麼出、月費怎麼算。
一件工作該交給哪個模型:先問三個問題
| 問題 | 偏向 Opus 5.5 這類頂規模型 | 偏向 Luna 這類便宜模型 |
|---|---|---|
| 內容複雜嗎? | 要讀懂大量內容再重新組織:整理、設計、做動畫和流程圖 | 照規則分類、回答固定範圍的問題 |
| 總共要呼叫幾次? | 次數少,單次貴一點,總額也有限 | 每天、每則訊息、每個訪客都要跑,先試便宜的 |
| 便宜模型考得過、錯了抓得到嗎? | 考不過,或錯了抓不到 | 用同一份考卷考過,而且有檢查機制 |
- 模型不是越聰明越好:我開始學著算 AI 的 CP 值 三個問題背後,是品質、時間、金錢一起算。
- 如何讓兩個不同的 AI 互相挑錯、自己訂正? 同一個問題的企劃版本:規劃交給頂規模型,其他交給便宜的。
模型分工提示詞:把你的工作清單貼給 AI 分類
把下面這段貼給你常用的 AI,後面接上你每週會交給 AI 的工作清單:
- 這篇提到過的
- AI 小工具該用便宜模型還是貴的?|同一份考卷考三輪,新模型出來就重新評估:Luna 交白卷之後,怎麼用同一份考卷重考。
- 模型不是越聰明越好:我開始學著算 AI 的 CP 值:分工背後的算法。
- 什麼叫子代理?從分頭查資料到 30 人工作坊頁面:交給 Opus 5.5 的逐字稿清理,就是開子代理做的。
- 再往前後延伸
- 新模型出來,我怎麼知道它對我的工作真的比較好?:往前一步。第三個問題要的那份考卷,題目、答案、成績怎麼保存。
- 讓 AI 定時整理資料前,先決定它多久醒一次:往前一步。扶輪社活動看板月費降下來,有一部分靠的是少跑幾次。
我是江江教練
隱性知識提煉師、AI 應用規劃師。我把自己每天在用的 AI 工作流程寫成文章與技能包,讓不會寫程式的人也能照著做。
如果你也在替自己的工作分配模型、算月費,歡迎來社群聊。
AI × 知識管理、隱性知識提煉,每月兩場免費線上講座的場次也會先在這裡公布。