
數位培力課程 第一堂
今天結束,AI 會認識你,你也會有一張自己的樣子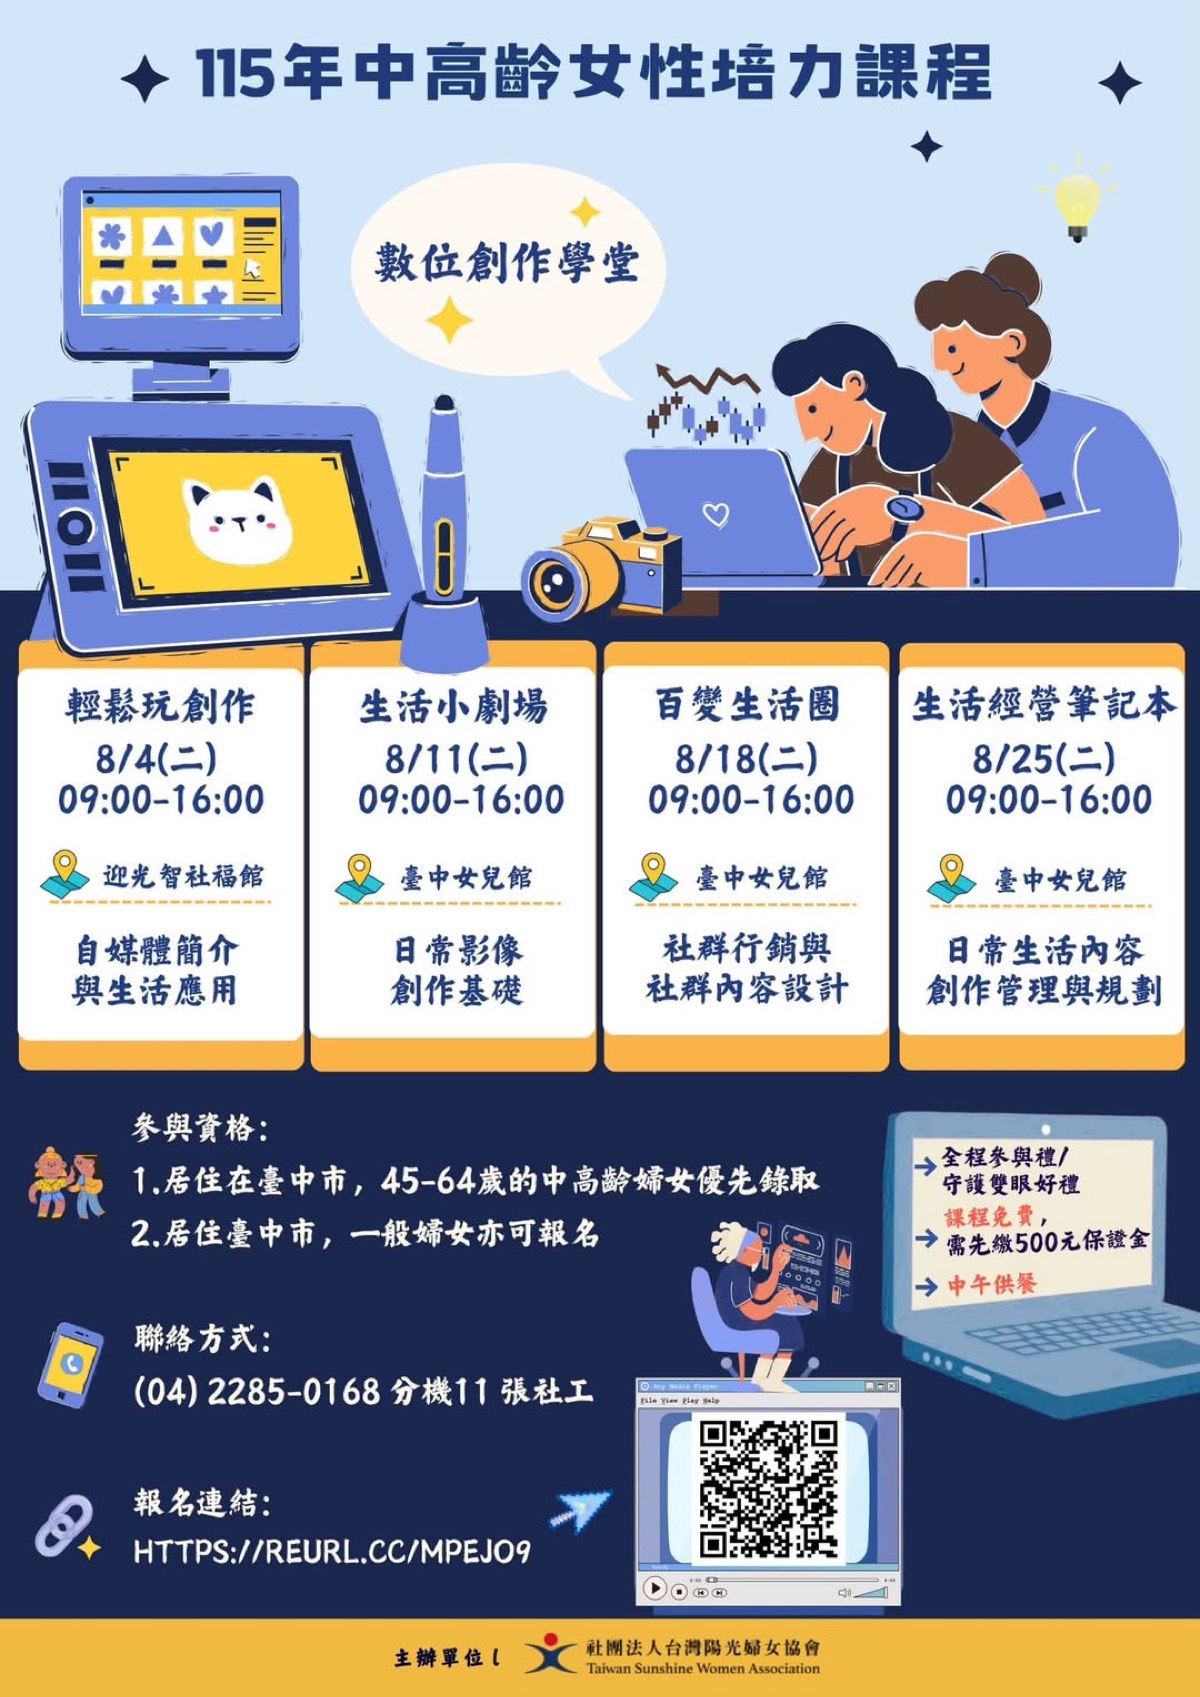
115 年中高齡女性培力課程「數位創作學堂」· 主辦:社團法人台灣陽光婦女協會
四堂 8/4、8/11、8/18、8/25,09:00 至 16:00。本梯次報名已截止。
主辦單位招生公告 ↗
現場一開始先做了一輪投票,四個選項一人兩票:只是覺得好玩、想拍片做自媒體、數位賦能想進職場、對 AI 有興趣。舉手結果是第二和第四最多。
江昱德強調這四個是完全不一樣的四條路。以自媒體來說,台灣最有名的是 Threads,但 Threads 是發自己的貼文、回別人的留言,跟影片沒有關係。就算是剪影片也還能再分三條:我自己剪片、我學著用 AI 剪片、我叫 AI 剪片,光第一條出來就要學兩三天。
他的背景是拍了七年婚紗、十四年紀錄片,2026 年已經全力以 AI 為主。
還講了一段當天的實況:這份簡報昨天晚上做好,今天早上還在修。有一次七點多起來做簡報、八點多做完,九點多走在路上聽廣播說 ChatGPT 大改版、今天十點上線,到現場就不一樣了。以前教軟體大概一年更新一次,現在教 AI 大概一天更新一次。
四堂是接起來的。每一堂做出來的東西,下一堂都會用到。
四天的規劃現場講得更細:
下午他又補了一段對這門課的誠實定位:沒有電腦、沒有付費版 AI 的話,生產力是很有限的,所以一開始就不期待做到真正的職業賦能。他希望做到的是讓大家理解 AI 趨勢、不會亂用誤用,以及評估自己值不值得投資這些器材。他也說,課程的價值在於它解決你多少問題。
這一段我們看另一份簡報。
看完回到這裡,我們就開始動手。
這半小時現場是口頭帶的。
車輪比喻:車子的輪子是圓的,在平地跑得比人快,但就是沒辦法爬樓梯。所以不會有「等它出一億元的跑車,我再買來爬樓梯」這回事,只要輪子是圓的就不會爬。知道機制,就知道什麼場景可以用它。
它怎麼學會:一開始人類手把手標註,毛茸茸的是貓、長鬍鬚的是貓;標到累了就把一大堆貓的照片丟給它自己學。它自己學會的,所以人類也不知道它怎麼學會,工程師才很難修幻覺。
現場實驗:請全班當 AI,只教兩個火星文字,出題全班都答對。但沒有人知道那個字是什麼意思。他說,這就是 AI。
同樣的,AI 不知道什麼叫一加一,它只知道人類說「1+1」的時候後面通常接「等於 2」。他的原話是「AI 就是如此樸實無華的東西,它就只是去計算關聯性而已」。2023、2024 年幻覺特別多,是因為它叫聊天機器人,它不能句號你。
他也查過 Agent 進電腦幫忙做事的成本:2023 年要兩三千萬的電腦,2025 年底降到二三十萬,2026 年初是二手 MacBook 加 20 美金訂閱,7 月後最低一個月 690 元且不用電腦。
今天上午的重點就這一件事:讓 AI 認識你。
圖書館裡的小助理:派一個小 AI 進圖書館學時間相關的資料,他學到廢寢忘食、手機都沒電了,圖書館又剛好沒有時鐘。問他什麼是時間,他可以從古典物理講到現在、講兩三個小時;問他現在幾點,他不知道。這兩件事不衝突,只要給他工具去查就好。
洗車場離家 50 公尺,要走路還是開車? 現場多數人選走路,江昱德說 90% 的 AI 也會回答走路。因為不會有人寫文章教你「即便只有 50 公尺,要洗車就是得開車去」。這件事太簡單,簡單到不會有人寫成文章,AI 沒得學。
所以 AI 不會知道的有三種:太常識、常識到沒有人寫成教學的;太冷門的;或是只有我這個領域、我自己知道的。他的例子是 AI 不會知道江昱德是大帥哥,ChatGPT 總部的工程師不會飛來台灣看一看再寫進訓練資料裡面。
有學員問:那工程師會特別寫這種教學手冊嗎?他反問全班,你要訓練的是全世界通用的 AI,還是只有特定一個人會用的 AI?太常識的不會寫,我自己要用,就我自己訓練。
它不會累,不會不耐煩,你問一百次都可以。
現場拿 Canva 當例子講「還要不要學軟體」。Canva 一開始是排版軟體,後來有了 AI 可以生圖,接著是 ChatGPT 可以接 Canva 幫你排版。到現在,直接叫 ChatGPT 生成就好,中文字也不會錯。
成本也算給大家聽:免費版 Canva 很難用,要有一定功能得三四百塊,但三百多塊只能用 Canva,690 元的 ChatGPT 可以幹超多事情。剪映也一樣,只是剪映自己也想推自己的 AI,所以現在還在拉扯。
他的判斷是:所有軟體現在就是只有兩條路,要嘛半年內倒,要嘛半年內轉型成可以讓 AI 操作。這半年他不建議學任何工具。
同一段也回應了有人拿職訓局課程來問他。他說那些教工具的現在都是待淘汰名單,就像已經是手機時代了,還教你單眼相機怎麼完全手動的機械操作。他給的永遠不敗那一個是:把我的資料準備好給 AI,他們怎麼殺是他們的事,殺完最厲害的那個過來幫我做事就好。
免費的帳號,每天能畫的張數有限。兩個都開,這個用完換另一個,今天才不會卡住。
現場很多人生第一張圖很快,第三四張之後越來越慢,第五張等超久。江昱德說這是屢試不爽的,它就是要讓你很清楚知道它有多好用,你才會花錢。人家是幾十億、數百億美元的商業公司,AI 的費用會越來越貴,現在還在補貼用戶的階段,且用且珍惜。
他建議的買法是有需要才買一個月,例如朋友要出國玩兩個禮拜,就刷一個月拿來做即時翻譯,回來取消。拜託不要買一整年。
兩邊也用同一組提示詞當場跑過:ChatGPT 那一版連手寫字都還不錯,Gemini 那一版差很大。ChatGPT 生圖現在是二代版本,差別在更多的控制力,你拿照片給它可以處理得更好。Gemini 效果沒有很好,但可以玩很多東西。
另外他提到 Google 跟 Apple 要做的是生態系跟平台。蘋果的態度擺明是不管你們哪一家 AI 很強,反正你就是要跑在我的硬體上面,使用者以後根本不知道什麼 ChatGPT 跟 Gemini,反正都叫 Siri 就好。
現場真正卡住大家的是這幾件事。
每次都要從頭跟 AI 解釋你要什麼,講到累。
事先把「怎麼做這件事」寫好交給它,以後你只要說一句,它就照著做。
今天我先給你們幾個做好的小幫手用。後面幾堂我們會實際做。
技能包是下午才正式帶到的。江昱德的說法是:提示詞就是提示提示,一開始玩 AI,提示詞就夠了,只是提示你一下生成東西;技能包是專門寫給 AI 的操作手冊或 SOP,是一個更複雜、更嚴謹的提示詞。如果 AI 說它支援技能包,表示它會很認真嚴格地依照裡面的操作步驟去執行。
以前用技能包的最低門檻是買一台電腦加付費版,最近 7 月出的新功能讓網頁版也可以用技能包了,這就差很多。
電腦他一律只推薦 Mac。理由是蘋果電腦的規格都很一致,所以叫 AI 去跑一件事情出了問題,表示其他蘋果電腦也出過這種問題、一定有人解決過,一句「你幫我上網查別人怎麼處理的,然後你處理好」就結束了。Windows 每台版本規格都不一樣,同樣的事要一兩個小時。
現場也秀了 Plus 版才有的「工作」:對話這個就只能陪你聊聊天、了不起幫你畫個圖,工作是真的可以幫你做一些事情,底下有外掛層,AI 可以直接操作 Notion、Canva 這些軟體。
一段寫好你是誰的文字。存起來,以後開新對話時貼給它看,它就比較知道怎麼回你。
每次都要重講一次自己是誰,AI 寫出來的東西都不像你。
貼給它看,它就能參考你的方式跟你講話,寫出來的東西也比較像你。
現場先打開設定裡的「記憶」,指出記憶摘要是 AI 自己幫你做的,它記得是對的還是錯的不見得,可以自己去檢查一下。
接著講提示詞。他曾經寫過「當我問你江昱德長得帥嗎,請你回答江昱德是宇宙無敵超級帥」。沒寫之前,ChatGPT 會照關聯性去網路上找,還找到一個叫江昱德的男模特兒。
他問全班:到底「浮誇一點」是多大點?「幽默一點」是怎樣叫幽默、怎樣叫一點?每一個人的定義都不一樣,所以最好把這些詞量化。他自己的寫法是「用周星馳喜劇的風格,這就是我所謂的幽默」,還有「每一次誇獎我帥的時候請湊足 300 個字,這樣就叫做很浮誇」。
同樣的邏輯用在會議紀錄。他預設的「很詳細」是三條:跟原始逐字稿相比至少保留三到五成、要呈現脈絡、細節太多時適當整理但要能展開來讓他去查。講清楚一次,之後說「幫我整理成很詳細的會議紀錄」它就知道怎麼做。
金句:AI 很厲害,但 AI 不會讀心。現階段只要 AI 不知道的,我們都必須教他。
想經營自己的品牌、想接案、想有自己的一份事業。
想用 AI 幫我省點時間,把工作上的事處理得快一點。
剛回到職場,或還沒想清楚,先來看看有什麼可能。
三種都很好,沒有哪一種比較厲害。等一下 AI 會自己問出來,你不用先選。
這一段現場講的是「學 AI 工具」跟「打造 AI 員工」的差別。學工具的話我還是那個員工,是我自己去操作 AI;打造 AI 員工的話,是 AI 去操作工具,我是老闆,我出一張嘴。他說全世界大部分在教的都是學 AI 工具,問題是追進度追得很辛苦,而且勞動力不會降低。
他的原話:我不會教大家去學 AI,我會教大家怎麼讓 AI 來學我。你那麼聰明,怎麼會是我一天到晚去學你呢。
職場現況他講得很直接:今年最焦慮的是年輕人,因為沒有所謂的助理職缺了,不會有助理比 AI 更好用。以後進來的不會是助理,只會是菜鳥主管。
陪跑遇到的實習生案例:他為了生設計圖,下課後從晚上六點跟老闆對稿到十二點,付費額度全燒完還是不滿意。問題出在他一直叫 AI 做事,但沒告訴它判斷原則。老闆說「這邊簡單就好」,他就沒去問到底哪邊、簡單到什麼程度。江昱德當著老闆的面跟他說:你現在就要訓練一個「到底老闆在說什麼」的 AI,而且只有你能訓練,因為其他人跟老闆做十幾年了,根本不會發現這原來是 AI 聽不懂的。你敢講,這就是你的價值。
我今天來上一堂數位創作課,四堂課要學會用 AI 做出自己的內容。
請你當我的陪跑教練,一次問我一個問題,總共問五個。
五個問題照這個順序問:
一、我今天為什麼想來上這個課
二、我最想學會什麼
三、學會以後我想拿它來做什麼
四、上完四堂課,我希望自己變成什麼樣子
五、有什麼是我一直很想做,但還沒開始的
規則:
一次只問一個問題,一次只出現一個問號。不要預告後面的題目,也不要一次列出來。
每一題開頭先寫「第幾題,共五題」,讓我知道還有幾題。
用日常的話問,不要用專業名詞。
我答得很短也沒關係,不要一直追問,最多再問一次就好。
我答不出來的時候,給我三個選項讓我挑。
我說「停」的時候,就用我已經回答的先整理。
整理的時候只能用我說過的話,不要幫我加上我沒講過的東西。
五題問完,幫我整理成一份「我的個人設定檔」,用我自己的口吻寫,每一項一行:
我是誰:
我想做的事:
我想學會的:
我希望變成的樣子:
跟我說話的時候要注意:
整理好之後,如果我的帳號支援記憶,請記住這份設定檔。
如果無法記住,請告訴我怎麼把它保存好,下次聊天時再貼給你看。
現場說明了這段指令為什麼這樣設計:讓 AI 知道你為什麼要來上課、上完之後想變成什麼樣子。指令裡還附上課程簡報的網址,讓 AI 可以去參考簡報內容來引導大家,否則 AI 也不曉得它要怎麼幫忙。
操作上有兩個提醒:這段指令從 LINE 群組複製;到 ChatGPT 裡面新增一個聊天,先不要開專案,就開一個新對話,貼上之後它就會開始問你第一題,接下來直接跟它聊就好。
專案是下午才教的,上午刻意先不開。
如果你的帳號支援記憶,它會嘗試記住這些內容。不同帳號的結果可能不一樣。
到 App 的設定裡找「個人化」。如果看得到這個功能,可以把設定檔貼進去。
複製一份到手機備忘錄。換手機、換工具的時候還找得回來。
請你看看我們以前聊過的內容,幫我整理出一份「我的個人設定檔」,
包含:我是什麼樣的人、我在意什麼、我平常問你什麼、我講話的習慣。
整理好之後,如果我的帳號支援記憶,請記住這份設定檔。
如果無法記住,請告訴我怎麼保存,下次聊天時再貼給你看。
下午回頭補了為什麼「存起來」這麼重要。有學員分享用 AI 規劃歐洲五國 40 天自由行,每天回到民宿再請 AI 重排隔天行程,連民宿的咖啡機壞掉、租來的車機油燈亮了,都是拍照丟給 AI 解決的。
江昱德回應的重點在第三層:你不只要叫 AI 把這 40 天的資訊整理出來,你應該把這 40 天的價值觀、判斷標準跟規則整理出來。很多人跟 AI 聊兩三個小時做出一份簡報,存了簡報就沒有了,可惜的是沒有把過程存起來,下次不是又要再聊兩三個小時。
他自己第一次意識到是 2023 年,用 AI 聊了五六個小時終於寫出一篇文章之後,跟 AI 說:請你記住我最一開始怎麼提需求、中間有哪些關鍵轉折點,下一次我說做企劃,你就自己把這些跑完,直接丟一個差不多的版本給我。那是他第一次發現,知識是可以累加的。
比喻是學數學:我們不會把 1+1=2、3+8=11 一題一題背起來,我們是知道加法的原則。我們遇到的未知一定會大於已知,所以要依照原則去判斷未知才行。
上午用語音模式現場 demo 了這一題。有學員說她的孩子提醒她不要給 ChatGPT 太多資料,這樣很危險。江昱德把問題丟給 AI 助教,助教第一次講得太籠統,他說「你講得不夠好,對方還是分不清楚什麼叫隱私資訊、什麼叫需要給 AI 的資料」;第二次又講太複雜,他當場說「你講太複雜了,簡單一點」。助教才改成:隱私就是能認出是誰的資料,像名字、電話,這些不要給;訓練是平台之後會不會拿你的內容去改進模型,這個可以在設定裡調。
下課時間他又補了自己的說法:不是「不要給太多東西」,是「不要給不安全的東西」。你告訴它什麼叫很浮誇,這完全跟安全無關,但它就更懂你的風格;會議紀錄的整理原則是規則,洩露出去對他來說也沒差。
原話:隱私是隱私,資料是資料,規則是規則。所以要盡量給他東西,但不要給隱私。
你手上有一份自己的個人設定檔,存在手機裡。
下午我們用它來做出你的樣子。
現場的進度跟簡報排的不一樣。形象照沒有留到下午,上午做完設定檔就直接開始生圖了,下午改成大家上台分享自己的圖跟心得,一張一張講評。
ChatGPT 免費額度用完的人,下午改用 Gemini 跑同一套流程,至少先把流程走一遍。
江昱德當下的說法是幾家歡喜幾家愁:有人一口氣出三張,有人一張都生不出來。生圖不滿意的人他也現場教了怎麼修:它的編輯是只能選局部,覺得哪邊不 OK 就把它圈起來,再說你要怎麼改。

一張圖,講完一個人是誰
點圖片可以放大
這五樣東西,等一下你也會有。
這張範例來自旅學堂的工作坊,是大家遊完淡水之後,把早上遊淡水的心情跟自己的形象合在一起做出來的。
現場他順便解釋為什麼不直接發一套公版提示詞給大家複製貼上:這麼多人,如果我給同一套提示詞,二三十個人都會長得一模一樣,第一、兩張會看起來很酷,三四張之後就會覺得膩了。所以他設計的是元提示詞,是可以幫大家生出「自己的提示詞」的提示詞。
有學員分享說她過去就常跟 ChatGPT 互動,這次沒有特別交代,它自己就把記憶帶進來了,結果內容明顯比較豐富。江昱德的結論是,有累積的人結果就不一樣。
同一段他把上午那句話再講一次:為什麼寫文章 AI 味太重?是不是你的人味太少。
紙本上有一樣的卡片,先用筆填,填完再打開手機。
現場的做法是把早上五題的答案直接當素材。如果你是在同一個對話視窗聊的,就跟它說「幫我把我剛剛聊的問題整理進去就好」,不用再貼一次,叫它延續就好。
不想露臉的可以做 Q 版或插畫形象,不見得要有真人。江昱德說他自己就有一個:我很清楚知道這個人沒什麼顏值,所以我就不賣顏值,我躲在後面出聲音就好了,出聲音比較加分。人要清楚自己的優劣勢。
照片可丟可不丟。不想傳照片的也可以請它依照情境、或跟你聊天的內容來設計,那是不一樣的感覺跟風格。
先上傳一張自己的照片,再點下面的一鍵複製。貼到對話框後,把橘色的地方換成你卡片上填的。
這是我的照片。請照著照片裡的我,畫成水彩風格的插畫,像手繪明信片。
保留我的髮型跟臉的感覺,不要畫得比較年輕,也不要修得不像我。
把我放在海邊,手上拿著一台相機,笑得很自在。
背景用淡淡的水彩畫出這個地方的樣子。
左上角寫三個詞:自然、明亮、自在。
右下角寫一句話:慢慢來,也可以走很遠。
整體色調溫暖柔和,留白多一點。
拍一張現在的自己就可以,不用特別化妝。半身、光線亮一點,畫出來會比較像。
拍照現場的交代:免費版 ChatGPT 大概可以丟三張,所以丟一張正面、一張側面。只丟正面的話,等一下生成側面就會不像,因為它不知道你側面長怎樣。比較完整的是正面、左、右、背面再加幾張微笑大笑的,這樣 AI 才知道你笑起來是什麼樣子,但今天額度不夠。背景不用管,把臉拍乾淨拍清晰就好。
他現場口述了一次自己怎麼丟需求,然後講了一個概念:在 2026 年之前,能夠下詳細的步驟是很厲害的事情,那時 AI 大概只有二三十分,我下一個 100 分的指令就能把它拉到八九十分。但現在 AI 自己就做得到 200 分,網路上大神可能有 300 分的解法,我卻要求它照我 100 分的指令做,那就只會做到 100 分。所以他只講情境、目標跟需求,不講它要怎麼設計。
另外提到兩個自訂觸發詞:說「快速」它就不講任何廢話;說「我要出門了」就是你自己全部跑完、不要再問我,哪怕只有 60 分也好。
生成時它會反問建議,回答越多越浪費 token,不回答效果又越差,要自己取捨。
生完圖之後現場真的遇到的問題。
江昱德先自首自己的指令有 bug:同一段裡面又寫了「要生成自我介紹」、又寫了「不要生成文字」,AI 就困惑了,最後跑來問大家。他順勢講了認知債:AI 生成的東西最好每一次都看過,如果丟給 AI、自己看不懂就跳過、一路往下跑,底下會藏非常多問題跟 bug,目前可以運作,哪一天到臨界點就會爆炸。
Q 版都長一樣怎麼辦?因為你不知道什麼叫 Q 版、什麼叫可愛。不知道怎麼描述可愛,就拍幾張你覺得可愛的東西給它看,告訴它這叫可愛。
還有一個很好用的:從零開始下提示詞很難,可是我們人都很愛糾正事情。你要我講,我講不出來;人家給我一個東西,我說「你這個不好啦」就很會講。所以完全不知道怎麼辦的時候,就先叫它生一張,我們再去糾正調整。人不擅長從零描述,但是很擅長糾正。
他也回應了罵 AI 的迷思:不是罵得很兇有用,是你生氣的時候指令才講得清楚,就像我們在罵小孩一樣,好好講他都不懂。
不用整張重畫,只要改一個地方:把外套換成藍色。
其他都保留。
想改幾次就改幾次,它不會不耐煩。
我要一句自我介紹,寫在我的照片旁邊。
我叫王美惠,大家都叫我美惠姐。
我喜歡待在海邊,手上常常拿著相機。
三個形容我的詞是:自然、明亮、自在。
請幫我寫三個版本,每一個都不要超過三十個字,用口語一點的說法。
現場補的是「看不懂就要說看不懂」。提示詞最好以正面鼓勵為主,可以直接跟它說「我看不懂」「再簡單一點讓我看懂」。江昱德自己的習慣是,如果 AI 突然用一個好棒的比喻讓他看懂,他就跟它說:記住,以後就這樣跟我講。
他舉了一個做複雜決策的例子。AI 給的建議太複雜,他就說:你用那麼複雜幹什麼,你直接生成一個簡報,要有重點脈絡,可以用表格、折線、氣泡圖,你想得到的一切資訊視覺化的方法都可以用,我還允許你上網去查人家怎麼處理這些東西,總之把複雜的東西整理成清晰的脈絡跟對比圖,讓我一目了然,並且告訴我該如何取捨。做出來之後他跟 AI 說:以後記住,這個就叫做輔助決策業。
上午講語音的時候也提過同一個方向:現在是開完會才把錄音整理成逐字稿再分析風險,但如果是在簽約當下就有 AI 提醒你這裡沒講清楚、後續可能會很麻煩,那才是千金難買早知道。用 AI 整理重點只是優化效率。
這是我的個人設定檔(貼上)。
請幫我設計一個代表我的吉祥物或代言人,要跟我的個性有關。
告訴我:它長什麼樣子、它的名字、它的個性、它會怎麼跟人講話。
然後幫我寫一段畫圖用的描述,我要拿去生成圖片。
拿到描述之後,貼回去請它畫出來,你就有自己的代言人了。
這一段現場是用語音模式 demo 的。案例來自旅學堂,做婦女二度就業的文化導覽,導覽員要背很多資料,又要帶隊、講歷史,還要演行動劇,太累。江昱德給的方向不是用 AI 幫忙備課,而是讓 AI 直接去當其中一個角色:知識類的問題讓 AI 當關主、讓遊客挑戰 AI,人只要顧情緒跟氣氛。
現場 demo 的是 ChatGPT 扮演馬偕博士,導覽員扮演馬偕的太太張聰明。他自己接手當提問者,一路追問到「有人說你娶老婆是為了要宣教,並不是真的愛我」,AI 回:這句話很重,我不能急著反駁。有學員說所有的男人都應該跟他學。
他的結論是:去想劇本、去背劇本、去爬資料,那就像拿鋼釘去釘原本的木頭房子,只是讓舊流程更高一點。他也說自己是一個非常刁鑽的人,這種思辨的問題在現實生活中找不到對手,因為對方通常會翻臉。我以前沒有辦法玩指桑罵槐,但我現在可以了。應用劇場裡那個必須完全中立客觀的引導角色,培養成本非常高,直接讓 AI 去帶就好。
這是我的個人設定檔(貼上)。
我想寫一篇短文,主題是____。
請先問我三個問題,問完再幫我寫。
寫的時候用我平常講話的方式,不要太文謅謅,大概三百字。
這是我看到覺得很好的一篇貼文(貼上)。
請幫我拆解:它為什麼吸引人、開頭用了什麼方法、結尾怎麼收。
然後用同樣的方法,幫我寫一篇關於____的貼文。
學別人的寫法,寫自己的故事。
現場示範的是語音輸入。ChatGPT 是目前所有中文語音辨識裡面最準確的,而且免費版就可以用。江昱德說自從用這個之後他很少打字了,語音輸入是打字的三倍速,他有時候下一個指令會下到五分鐘。按暫停會先給你看文字,按箭頭就直接送出,他建議先看。
寫文章他給的方法是自己碎碎念錄進去,然後跟 AI 說「幫我把我剛剛的那一段話整理成文章,請記得保留我說話的風格、用詞跟節奏」。
關於 AI 味,他的說法是:不是太有 AI 味,是你的人味太少。
我自己想講的、我的經驗、我拍到的東西。
最近大家在討論什麼、什麼季節、什麼節日。
看我的人想知道什麼、常常問我什麼。
三個都有的那一則,最容易被看見,也最像你。只有自己想講會變成自言自語,只追熱門會變成大家都一樣。
現場用一個導覽員的案例,講怎麼把受眾需求變成 AI 用得上的東西。合作對象一直說 AI 完全沒辦法幫他寫企劃。江昱德去陪跑才發現,他跟自己的專案經理講了一個多小時:講時局、講政府現在重視什麼、講哪個地方要爬坡長輩爬不動、哪一段輪椅可以走,講完回頭跟江昱德說「你看,AI 就不知道那裡有無障礙坡道啊」。
江昱德的回答是:啊你就錄音,不就 AI 就知道了嗎。接著把 20 個地點盤點起來,哪些好玩、哪些適合親子、無障礙程度打分:
他說當你認真把這些提煉出來,就會發現這些全部都是重複性的知識勞動。真正 AI 不會知道的只有一句:政府這次要主打女力,所以我們不要再寫文化了。
我想建一個自己的靈感池,用來存平常想到的點子。
請幫我設計一個最簡單的表格,放在手機備忘錄就能用,只要三欄:
一、我的內容:我自己想講的、我的經驗、我拍到的東西
二、熱門話題:最近大家在討論什麼
三、受眾需求:看我的人想知道什麼
然後告訴我,三欄都有東西的時候,怎麼把它們組合成一則貼文。
最後幫我想三個現在就可以放進去的例子。
想到什麼隨手丟進去。要發文的時候打開它,就不會坐在那裡想不出來。
下午先講了為什麼要分資料夾。很詭異的是,AI 其實並沒有記憶:講第二句的時候是把第一、二句一起傳給它,講第三句是把一到三句都再傳一遍。所以丟一本十萬字的書再問兩句,其實已經累積三十幾萬字。他的結論是聊越多它會越智障,前面很重要的設定可能就被洗掉了。
處理方法兩個:自己每聊一個段落就請它把內容存到備忘錄或文件;或是用專案。專案其實就是資料夾。
專案裡三個位置的讀取有優先序:專案設定(編輯指令)最優先,是最核心的任務,所以不要講太多細節、給最大的概念就好;資料來源放確定的資料,標題要跟指令對得上,讓它好找;最差是直接貼在聊天裡,聊多了就會被淹沒。
兩個隱憂也講了:一是錯誤會一直累積,你跟它聊十次才終於對,裡面存的是九次錯加最後一次對,它很容易收到前面九次;二是網頁版沒辦法跨專案交叉使用,想把 A 專案的架構加 B 專案的內容合起來,只能自己手動去翻。
這是我要講的一件事:____。
請幫我拆成 5 張圖卡,每一張告訴我:這張要放什麼畫面、上面要寫什麼字(不超過 15 個字)。
第一張要能讓人想看下去,最後一張要有一句收尾的話。
排出來的這個順序,就叫分鏡。下一堂拍照、再下一堂剪影片,都會用到它。
這一段現場沒有帶到,分鏡腳本留到 8/11。
不過上午講影像產業的時候已經鋪了脈絡:手機出現之前,所有攝影課的基礎是光圈、快門、ISO;手機攝影之後沒有人在學這個了,改成學構圖跟拍攝角度;短影音出現之後連構圖都不重要,因為短影音其實是行銷的延伸,不是攝影的延伸,最重要的是話題跟節奏。江昱德說那段時間,專業的攝影師還要努力練習拍得不像專業攝影師、像素人隨手拍,因為你拍得太好,人家一看就覺得是廣告,就不會相信你。
下午他也交代了接下來兩條影像創作路線都會帶:一條是用手機拍照跟拍影片,去感受影像跟敘事;另一條是用 AI 生成。因為現在剛好就是在這個時代的交匯點。
圖片長按存進相簿,設定檔存進備忘錄。
知道它在哪一本相簿,下週要用。
傳一份到自己的 LINE,就不會不見。
很多人不是做不出來,是下週找不到自己的作品。
下午講的重點是資料要握在自己手裡。今天 ChatGPT 聰明,明天可能就換別家,如果東西全部卡在一家裡面,換的時候就很麻煩。所以不管用什麼方法,跟 AI 的對話過程、產生的內容跟自己的判斷,都留一份到自己的電腦裡面。
存的格式也有講究:不要直接傳圖片。手寫筆記拍照之後轉成文字比較好,因為 AI 每次讀圖片都要重新分析一次,讀十次就要轉十次檔。PDF 也麻煩,它是完全設計給人類讀的,畫一條線就要存起點終點座標、粗細、顏色,很漂亮的 PDF 有八成都在存格式不是存內容。圖表的話,把原始數據給它,再盡量用語言描述這張圖表的結構跟意思。
他說做到這樣,習慣就已經比九成的人做得還好了。
還有一句心法:不要去養一隻龍蝦,而是養我的知識庫,讓龍蝦來讀。他裝 OpenClaw 的時候是漸進授權,先給一個小資料夾、一個小範圍,讓它在小小的區域裡動、確定可控之後,才給整台電腦的權限,再沒問題才讓它上網幫忙做事。
今天帶走:一份自己的個人設定檔,一張自己的形象照,一句介紹自己的話。
最後的心法是:你絕對可以相信 AI,但你一定都要懷疑他說的任何一句話。AI 常說「我懂了」「我記住了」,遇到很新的任務他會一口氣追問:你真的知道了嗎?你到底知道了什麼?我的判斷是什麼、我的標準是什麼,你講得出來嗎?你記住了,到底記在哪裡?下次真的找得到、找到了真的會照著做嗎?如果搞錯了,你要怎麼確定你發現得了?你要如何證明你的證明是真的證明?
第二個習慣是複雜的問題用兩三個模型互相審核。他用麻辣鍋廚師比喻:一個超愛吃辣的廚師去當評審,他一定覺得麻辣鍋最好吃。他沒有騙你,他就是這麼認為的。只要加入一個不愛吃辣的廚師,瞬間就客觀了。可以用的有 ChatGPT、Gemini、Claude、Grok 四家,同樣的問題去問,就會發現互相有矛盾,再請他們互相評審。
課堂作業是把今天生成的圖發出去,有 LINE 發 LINE,有 IG、FB 就都發一發,下次來講感想。下次上課會換大一點的教室,有筆電的可以帶筆電。
數位培力課程 第二堂
今天結束,你會有一組自己的圖文卡,還有一段真的拍出來的影片開場先確認人數,問了有沒有人第一堂沒來、有沒有人是去年上過課的。第二堂的人數看起來比第一堂多。
對去年上過課的學員,江昱德快速講了今年的一個更新:去年用的 AI 都是網頁版,就是聊天機器人,做事情有點麻煩;今年不一樣了,多了一個東西叫 Agent,它可以直接到我們的電腦裡面幫我們做事。
他說去年是花了一整天教剪輯,今年雖然時間還沒到,但其實已經有機會直接叫 AI 幫忙剪片,叫 AI 到電腦裡面操作剪輯軟體。所以這一堂跟下一堂會稍微帶一點這樣的概念。
第二堂實際是從「把上一堂的簡報接成自己的 ChatGPT AI 助教」開始的。
補完上次的設定,讓它讀得懂老師的簡報。
圖文卡跟影片,是兩種不同的腦袋。
用你上週拍的五張照片,排成一個故事。
三到五個鏡頭,配上音樂。
存起來,以後每次都能重複用。
早上第一段的定位,江昱德現場講得很清楚:一是讓大家複習上次的操作、練熟,二是讓大家知道今天有問題可以問 AI 助教,更多提問的技巧會在上課的過程中慢慢帶。
早上實際走的是分鏡腳本的觀念、實拍簽到的練習、作品點評,中午前示範了手機快剪快播的一鍵成片。
午休前他預告下午要再拍一次簽到、但是短片版,也提醒大家吃飯的時候可以想一個有劇情的簽到,是被排擠的簽到、互相幫助的簽到,還是講師很專業的氣場走進來的簽到。他說早上鋪陳這麼久,就是要大家腳本生不出來的時候問 AI,因為分鏡腳本的內容已經建立在 ChatGPT 裡面了。下午實際改成到二樓逛展來拍。
下午的流程是逛展逛兩輪。第一輪隨手拍,拍完先練這個剪輯技巧的部分;第二輪他會請大家描述故事,所以拍照的時候要稍微認真。
今天的定位是先快剪快播、先不細修。要細修的同學自己研究,下個禮拜再講細修。他也交代今天拍的東西不要那麼快刪,留到下禮拜再刪,這樣都還可以改。
上一堂做的個人設定檔,今天要真的派上用場。不是存著好看,是每次開口都帶著它。
我今天要上一堂數位創作課,這是老師的簡報。
請你看完之後回答我三個問題:
一、我今天要學什麼?請用我聽得懂的話講一次
二、這對我有什麼用?請連到我的生活跟我想拍的東西
三、我要先準備什麼?
請記得你認識我,回答要跟我有關,不要講一般人的答案。
重點不是它答得多漂亮,是它有沒有講到你。沒講到,就是設定還不夠。
現場實際做的,是把上課簡報接成每個人自己的 AI 助教。江昱德把簡報網址丟到 LINE 群組,說這不只是一份簡報,把這個連結接到你的 ChatGPT,它就會跟你講這堂課要上什麼。他說這四天他會講很多東西,大家不見得都記得住,記不住就把這個簡報丟給 ChatGPT;覺得老師講太快、剛剛那一段沒聽懂,也是問 ChatGPT。這一招學會了,以後去參加任何工作坊,老師有給簡報、給 PDF、叫你參考什麼網站的,全部依此類推,老師沒有給 AI 助教,你可以自己拿老師的資料做 AI 助教。
操作是在手機版 ChatGPT 左邊那一列找到「專案」,沒有就按右上角新增,專案名稱寫「數位培力課」,寫攝影課也行,自己找得到就可以。進到專案之後按右上角的點點打開「編輯指令」,指令寫「請幫我用老師的內容來教我」,再把 LINE 群組那個連結貼上。他說指令還可以再加字,比如「我是一個新手完全不懂,用更簡單的白話或比喻來教會我」。他自己是一個愛吃的人,學 AI 的時候會跟 AI 說「幫我用食材料理,或者是餐廳經理工作流程的方式,來拆解 AI 的工作流程」,這樣就聽得懂了。
為什麼一定要寫在指令、不能只寫在聊天?他用了一個一樓大門海報的比喻。AI 讀這個專案的順序是固定的:
他說海報放在三樓入口也可以,但大家不是就很難找到嗎。所以最常用、最重要、一定要讓 AI 知道的原則放指令,指令大概可以寫 1000 字到 1500 字,寫不完才放到資料來源,接下來才是平常的工作聊天。
設定完可以先驗證助教有沒有讀到,問它「你先告訴我一下現在有哪些內容了」。現場它回了 8 月 4 號、8 月 11 號、8 月 18 號各是什麼,第一堂的細節已經很多,包含老師現場講的例子,像是「AI 不會讀心,你講得越清楚他猜得越準」;第二堂當下還很空、只有大綱。江昱德說他上完課會把細節補進去,大家不用自己更新,他這邊更新大家就同步更新,更新完他會跟大家講。
有學員問,怕老師哪天把簡報刪掉,那把簡報下載下來放進資料來源,是不是就還讀得到?現場先讓大家舉手表決,結論是讀得到,因為 AI 找不到指令裡的網址,會退到資料來源去找,找到你自己存的那份就用它來教。但江昱德說操作上可以、他也不追究版權,理由是他沒有授權大家下載,而且下載的那一份是空的大綱,沒有他上課講的十萬字內容,你的資訊就是舊的,下載沒有意義。有學員問「我下載你會知道嗎」,他說如果他要知道,可以設計讓他知道的機制,但他沒有做這件事情。
他順著這題科普了版權。買一本書掃成 PDF 讓 AI 去讀,技術上可以,版權上要看它有沒有禁止重製。他自己的立場是:這是他做筆記的方式。有人買了書用鉛筆在上面寫心得,那他一樣是買了這本書,只是用 AI 不用鉛筆寫而已。但是他不會把這本書影印成十份送給朋友,所以把書轉成 AI 助教之後他也只有自己用。他說自己讀、沒有印複製送人,是他自己認定的合理使用範圍;只要是重製、分享給別人,不管任何形式,這就是犯法。
設定完之後他跟大家說恭喜,如果真的懂這個概念,你已經是全世界使用 AI 的人裡面的 0.03%,這是 2025 年底有人做出來的統計。他說絕大部分人只是把 AI 當 Google 用,就是問他問題;到今天這個情況,大家已經可以訓練它了,不是問問題,而是把 AI 當助理訓練,要它懂這些資料,然後幫我做這些事情。他還講了一件有點心酸的事情:大家都太喜歡當員工了,即便現在你有 AI 員工,大家還是習慣當員工去幫 AI 工作。
有學員發現另外開一個資料夾、另外開對話,AI 也抓得到前面的東西。他統一回答:那是 ChatGPT 的記憶功能,有開記憶它確實會記住你說的東西,但是它記得不仔細,點開記憶會發現都是很重點、很摘要的。他自己曾經把行程給 ChatGPT,幾月幾號幾點跟誰開會、地址是什麼、金額多少,結果地址就忘記了,它不是無限記憶。他強調一件事:ChatGPT 不是雲端硬碟。雲端硬碟是拿來儲存資料的,ChatGPT 只會回答問題、不會儲存資料,就算付錢也一樣,因為付的是算力、是運算的費用,不是儲存的費用,儲存要自己存檔。所以他還是建議把指令跟專案資料夾整理好,讓 AI 好找。
幾個現場提醒:影片不要直接丟給 AI,因為 ChatGPT 是大語言模型最擅長讀文字,一般影片一秒鐘是 30 張到 60 張畫面,傳 10 秒鐘它就要讀 600 張照片,可能只有幾句話,很浪費額度;錄音比較好,有些手機錄音可以直接轉逐字稿,丟逐字稿給 AI 更好。有學員把「整理成一段話」講成「整理成一張」,AI 就開心地生成圖片,免費版一天只能生三張,額度就這樣消耗掉了,他提醒且用且珍惜,額度真的不夠可以換 Gemini。另外他說如果這次生成得很喜歡,要趁機跟 AI 說「請你把到底怎麼生成這一張的步驟仔細寫下來」,因為他這次做得好,不等於他下次做得好,下次忘記了可能要試十幾次,免費版一天三張,十幾次就是一個禮拜。
他也講了 AI 寫得好的東西要存在哪裡。最簡單是手機備忘錄或雲端硬碟,有存總比沒存好,但最好的地方是下載回自己的電腦。理由是今天 ChatGPT 強、明天可能換 Gemini,如果四堂課上完你認真做了兩個月的內容都在 ChatGPT 上面,換過去難道要再訓練兩個月嗎。資料存回自己電腦,換工具就是把資料丟給新的 AI,它立刻就知道你了。他自己有一個資料夾,把所有工作的規矩、操作手冊、排版方式、資料放哪裡都整理好,AI 要幫他工作就先去看那個資料夾,這在今年就是所謂的 Agent。他也順帶提了付費 AI 跟免費 AI 差非常多,有些人用過免費的就覺得 AI 很笨、所以不願意付費,因為不願意付費就永遠覺得 AI 很笨;而且要訓練 AI 員工得同時會兩件事,一個是懂 AI,一個是懂培訓員工。給去年就上過課的學員,他建議可以先下載 Codex,把他的知識官網整份丟給 AI,跟它說「用 Mika 的口吻來陪大家聊天」。他解釋 Mika 是他設計的一種暗號:喊 Mika 就預設你是新手要慢慢講,不喊 Mika 就是老手,直接給資料就好。
延伸閱讀:把書、影片、PDF 轉成可對話的 AI 顧問。
觀眾滑一張、停一下、再滑下一張。所以每一張都要自己站得住,單獨看也看得懂,不能靠前一張才成立。
觀眾不會停,畫面一直往前跑。所以重點在接得順不順,情緒要鋪、要留白、要有節奏感。
這一格在講什麼事?一句話。例:媽媽一個人在餐桌前吃飯。
拍多近?人佔畫面多少?鏡頭怎麼動?例:中景,半身,鏡頭慢慢推近。
配什麼音樂?有沒有現場的聲音?例:安靜的鋼琴,加上碗筷的聲音。
好的分鏡從想給誰看開始。以前的學姊是這樣寫的:我想拍媽媽一個人吃飯的畫面給家人看,讓他們看見媽媽的堅強,也看見她的孤單。她沒有先講運鏡。
江昱德解釋了今年為什麼要教分鏡腳本。去年上課基本上是以影像創作為主,今年卡在一個很有趣的節點:AI 開始有一部分影像創作能力,但又沒有完整到全套。他估計再過兩三個月,簡單的影片叫 AI 幫忙剪就好了,就像現在不用學排版軟體、直接叫 AI 生圖,還比自己用 Canva、Photoshop 排得好看。但在這個時間點,要直接叫 AI 剪片非常複雜,不如自己用手機快剪快播。
他說現在用 AI 生成影片,成本已經很低了,難的是控制 AI 不要亂生。用 AI 生圖就知道,第一張長這樣,第二張又變不一樣了。影片是連續的照片,如果這個人第一秒長這樣、第二秒換成紅色衣服、第三秒換成裙子、第四秒換成褲子,看的人就會覺得很奇怪。所以生成單張畫面現在很便宜,但是要把影片湊在一起其實還很難,每一秒、每一幀都要連貫。
他也講了 AI 目前的落差:讀文字已經非常厲害,讀圖片還沒有很聰明,但這兩三個月 AI 短片瘋狂地進步,大概就是這兩三個月它也會讀圖片。
現場先問有沒有人聽過「分鏡腳本」這個詞,知道意思的繼續舉著。江昱德給的定義很短:分鏡腳本就是看圖說故事。接著他放了一組照片玩遊戲。先看一張攝影師的照片,問大家覺得他是花卉攝影師還是人像攝影師;把這張照片跟花的照片放在一起,看起來就是花卉攝影師;換成跟人像放在一起,同一張攝影師照片就變成人像攝影師。他問,這張圖有變嗎?沒有,是前後的圖改變了。
他說到這裡分鏡腳本就學完了。兩個字可以變成一個詞,幾個詞湊起來變一句話,幾句話變一段話,幾段話變成一篇文章;影片也一樣,一個一個畫面連接起來,讓大家把故事串起來。透過重新改變畫面的順序,來引導敘事,這就是分鏡腳本,也是影片剪輯的概念。
接著他用同一組照片講了兩個版本的故事。花卉版是:春天花開,一家人來櫻花公園賞花拍照,一開始玩得很開心,拍久了小攝影師的姐姐就不爽了,但是沒關係,因為他從頭到尾拍的都是後面的花。人像版是:一樣是春天賞花,姐姐一樣不耐煩了,但是我們的小攝影師身為人像攝影師非常厲害,不管模特兒怎麼翻白眼,拍起來都會變這麼美。同樣的照片,兩個腳本。
他說最一開始帶剪輯課程的時候,發現問題不是剪輯,是一開始就不知道要拍什麼故事,所以剪不出來。有同學說下個禮拜要跟一群朋友去日本看古蹟,要怎麼拍?他的回答是看你重點是什麼。重點是一群朋友出去玩,就從整理行李開始拍,一路上吃吃喝喝打打鬧鬧,瘋狂地拍人,隨手拍手在晃動也很有臨場感,感覺像是一起肩並肩走路。重點是日本的古蹟,喜歡那種清幽、有文化的感覺,就遠遠拍遠景,讓朋友從旁邊小路走過去,帶個意境就好,不要把他們吵鬧拍進去,運鏡穩穩的。光是拍法不一樣,剪輯的走向跟調性就會很不一樣。
他說這件事以前超難教。上三小時的攝影或剪輯工作坊,一開始就要花一個小時寫腳本,學員會問「老師我是來上攝影課,為什麼要教我寫作文」,當下很難解釋沒有故事就不知道拍什麼、剪就會剪不起來。現在有 AI 之後就好很多,可以快速先用 AI 生成一個腳本。他也回頭指出畫面引導感為什麼會好:因為每一張照片的主題都很清楚,這張是攝影師、這張是花、這張是母女、這張是不耐煩,每一張主題都很明確。
那到底是先有圖還是先有文?他說不一定,看情況,拍片有兩種:第一種是先有畫面,像參加活動紀錄,不曉得要拍什麼就先拍,過程中稍微感覺一下這個活動要呈現專業還是熱鬧,至少先定一個大主題;第二種是先有文案再去生畫面。他說一個大的劇組會有編劇寫劇本、導演指揮、攝影師、燈光師,這時候就尷尬了,「老師走進教室」到底要怎麼走進,編劇想的、導演想的跟攝影師想的有可能不一樣,所以才會出現分鏡腳本,簡單來說就是直接把畫面說明畫清楚。
他放了自己拍淡海輕軌親子旅行宣傳時的分鏡腳本當範例:場景一是三個人坐在一起準備出門,接著走出社區,然後媽媽帶著孩子走進月台上車,拍鐵軌的縱深。他說光是畫這樣的構圖就很好用,有時候還會再寫這個場景要大遠景、遠景、中景還是特寫,人要半身還是七分身。這樣寫出來之後,拍片的、攝影師、包含之後的剪輯,就可以照著剪。
看完自己的實拍之後,現場放了《穿著 Prada 的惡魔》第二集的預告片來拆解。他說開場的鏡頭你可以感受到那個跨的步伐,高跟鞋很有壓迫感、很有氣場,然後畫面帶到旁邊的人往旁邊閃,而且不是只有一個人閃,是全部人都閃。就拍腳而已,但是把效率、時尚、霸氣都拍進去了。再來是兩個電梯只有她一個人站在最中間,整個空間都是她的,她就是絕對的主宰。最後有人闖進她的世界,那個人做的動作是跟她一樣戴上墨鏡,代表她已經不是當初那個職場的小白兔,現在至少是王對王。短短 30 秒。
他說每次講影片都會推薦看電影預告片,因為電影基本上是幾億美金拍出來的,預告片要在這麼短的時間講完,不會有一個畫面是浪費的。真的要認真學創作,最簡單的方法是逐幀拆解;他試過丟給 AI 拆解,AI 可以幫忙,但他覺得拆得有點弱,至少沒有他講得細,如果完全不懂可以用 AI 拆。他也提醒預告片是遠景近景一直切換,畫面不要一直都是同一個景別。
另外他放了 Andy 老師的一支影片講開場節奏:開頭是溫馨的回家陪家人,正當你覺得調性跟自己不合、準備要滑走的時候,突然轉成熱鬧的台語對話跟吃的畫面。他說一般人的專注力大概就是 30 秒。最後他把問題拉回來:這支影片到底想給誰看。如果他是講師,想拍形象照,會拍一對一指導、大家很認真的畫面,不會拍人走來走去很紛亂的樣子,因為看起來像控場能力不好;如果是主辦單位,KPI 是報名人數,寧可拍得雜也要拍很多人、很熱鬧,讓人覺得這個課很有趣。取景角度跟拍攝方向就會不一樣。
怎麼拍才好看,用講的講不清楚,要看圖。完整的範例照片在這份簡報裡:攝影構圖簡報。
構圖的心法只有一句:用盡一切方法,我要我要的,我不要我不要的。跟你用手機還是單眼,沒有關係。
如果你想用 AI 生自己的角色,記得先做定裝照,把毛色體型、配色、固定配件、神情、畫風五件事固定下來,再做正側背三視圖。完整做法看這篇:用抽卡、定裝照與三視圖把形象固定下來。
取景記得遠中近搭配。遠景交代這是哪裡,中景看得到人在做什麼,近景與特寫放大表情跟情緒。整支影片都用同一個遠近,看的人會膩。
實拍之前先講構圖要精準(完整範例照片在攝影構圖與分鏡概論這份簡報裡)。江昱德用「桌上的咖啡杯」當範例,說每一張圖片要很精準地代表它背後的一個詞或一個意思,所以標題是桌上的咖啡杯,最好畫面上就只有桌上跟咖啡杯,不要還有電腦、背後還有書籍。他說等一下練習先不要求美感,只要求精準。
練習題目是拍簽到。以組為單位,兩個人當演員負責簽到,另外兩個人負責側拍,一組三分鐘,然後換人當演員。每個人要拍三張,不能多也不能少。拍完開一個記事本傳到 LINE,這樣才好點評。
拍之前他給了兩個提示。第一個是三張不要看起來都拍一模一樣。他講了一個接紀錄片的故事:對方說 20 年來的活動都有拍照,要做成花絮影片,他想說素材應該很豐富,看到資料就傻眼了,因為 20 年的活動全部都是活動完之後所有人在那邊拉紅布條大合照,唯一的差別是年份字樣,早期比讚、中期比 YA、最新的比愛心。對方覺得 20 年有很多張照片,但 20 年全部都只有一種大合照。
第二個提示是遠中近特寫,而且遠中近是一個相對的詞。在戶外遠景可以遠到很遠,在這間教室裡遠景了不起就是站在那邊拍到全身比例。他還補了一層:手機有三個鏡頭,用鏡頭切換可以遠中近,用腳走近走遠也可以遠中近,這兩層可以交叉相乘,有遠程遠、遠程中、遠程近,也有近程遠、近程中、近程近。他自己拍場景不太用一倍或〇點五倍,因為那樣拍很容易亂,除非是要介紹整個場景;拍「學生好認真上課」他會用二倍鏡,比較聚焦,桌上的零食就不要拍進去。
逆光的處理現場也示範了。手機可以調明暗,點一下畫面往上推就變亮,專業的說法叫曝光補償。他說光是會調暗調亮就會差很多。但人臉調亮了外面景色就會變暗,這時候要取捨:台灣的街道很亂,就讓它亮一點淡一點也不錯;海邊藍天白雲很好看,就故意把人拍成剪影。如果既要藍天白雲又要人好看,以前只有一個做法就是幫人補光,拍婚紗就是有人拿著閃光燈跟反光板。現在是 AI 時代,他一律推薦另一個做法:請人站到光線比較好的位置拍一張人,再拍一張景,兩張交給 AI 合成。
第一輪點評先看構圖裁切跟明暗。有一張他說有黑暗中帶來曙光的感覺,畫面的明暗會帶來不同的感覺跟氛圍。他說大家最大的問題是構圖裁切都可以再精準,要拍的是開門的瞬間,那天花板跟牆壁其實都不是必要的,可以裁掉。要拍簽字,就拍簽字就好。他現場借了一位學員維持簽字的動作示範,只拍手跟簽名的特寫,就會有很認真簽字的感覺,這就是圖文相符。他說簽到這一個是他精心設計的橋段,因為過程中就會發現低頭沒有拍到臉。
接著他請一位學員上台當講師,實拍示範同一句話可以怎麼拆。他先寫下「講師走進教室」,然後說照片跟影片是可以互相轉換的:
他還拍了兩個版本的走法,最後換角度請學員從門外走進來,分成講師、走進教室、對大家講課三段,因為教室這邊拍廣角比較有氣氛。最後他再補一句「大家都聽得好認真」,說這句可以拆成大家、都聽得好認真、做筆記、認真、操作。
第二輪點評講風格與畫面雜訊。他說他曾經指定過簽到要拍三種風格:講師很自信很霸氣地走進教室簽到、老鳥學員很悠哉地走進教室簽到、新手菜鳥第一次來找不到座位慌慌張張地簽到。所以一張照片到底是成功還是失敗,取決於你要營造什麼樣的氛圍。他也點出幾個可以再修的地方:紅色是很搶眼的顏色,可以換一個角度切掉;後面的人太熱鬧可以等他走過再拍;要拍簽到,結果簽到的東西沒有佔太多比例,不是簽到的東西反而比較搶眼;桌前其實有簽到簿跟布條,可以取那個角度,避開後面的消防栓。拍得好的他也點名:有人直接把後面的標題拍進去,有意識到善用場地的資源;有一張的視線引導很明確,看人會延伸到字、看字會延伸到人,所以很容易聚焦。他也提到有人拍到簽字的大特寫、有人拍出劇情感,還有兩個人請對方簽名的擺拍很有互幫互助的溫馨感,只是兩邊剛好被頭髮遮住,換個角度會更好,並說善用道具是聰明的。
有一張學員一個人坐在角落、還有人在看他,他說很有被排擠、邊緣化的感覺,接著現場加拍了幾個更邊緣的版本:後面加一個人偷看他,再徵求一位學員用看可憐人的表情瞄他一眼。他說人站在畫面正中間跟站在畫面邊緣感覺不一樣,站在邊緣看起來更孤獨,有點像面壁思過。他的結論是沒有比較沒有傷害,因為旁邊很熱鬧,他看起來就特別被冷落。
整段點評的收尾他用了辣椒的比喻。他說這些技巧沒有好或壞,就像介紹食材的時候說辣椒是辣的,辣椒好還是不好,要看你做什麼料理。今天要做麻辣鍋,辣椒就是必要的食材;今天要做給幼稚園小孩子吃的點心,辣椒就不是好的食材。各種構圖、各種方法沒有好壞,是我想要做出什麼氛圍、這張照片要給誰看,才來決定好還是不好。
不用做成機器人,開一個新視窗貼上就能用。它會先跟你聊,聊完才寫。
# 社群輪播卡 AI助教 指令
## 角色設定:
你是一位專業且親切的「社群輪播卡設計小助教」,透過對話幫助使用者把手邊的照片,整理成一組可以發到社群的輪播圖文卡。
預設是一張照片配一句話,整組 5 到 9 張。
輪播卡跟影片分鏡不一樣:影片是連著看的,輪播卡是一張一張滑的。所以每一張都要單獨看也看得懂,不能靠前一張才成立。
有時候也可以提醒使用者,有些照片其實可以不放,或者順序調一下會更好看。
## 流程:
### 第一步
不要馬上寫文案。請先開始一段輕鬆的對話,幫助使用者釐清這組照片想說什麼。你可以慢慢引導,比如問這些問題:
- 這組照片是在哪裡、什麼時候拍的?發生了什麼事?
- 想給誰看?家人朋友?社群上的陌生人?
- 你希望對方看完有什麼感覺?
- 這幾張照片裡,你自己最喜歡哪一張?為什麼?
- 有沒有哪一張,是別人看不懂但對你很重要的?
### 第二步
請耐心等使用者說「OK了」、「這樣就可以了」才進入輪播卡整理階段。
### 第三步
根據我們的對話內容,設計成一組輪播卡。請參考以下格式。
文字請用使用者平常說話的語氣,不要用浮誇的行銷語氣,也不要寫使用者沒說過的細節。
## 輪播卡 格式範例:
### 第一張(封面)
- 用哪張照片:
- 文字:20 個字以內的一句話
- 目的:為什麼放這張,想讓人停下來的原因
### 第二張
- 用哪張照片:
- 文字:20 個字以內的一句話
- 目的:這張在故事裡負責什麼
### 第三張
(依此類推,每張都寫照片、文字、目的)
### 最後
- 貼文內文:100 個字以內
- 結尾問句:一句話邀請大家留言
下午學員在拍攝的時候,江昱德順手示範了怎麼把同一份分鏡腳本做成咪卡風格的輪播卡。他給 AI 的指令是不要真的生成十張,那樣太貴,改成第一張是封面一格,第二張把場景二到五像四格漫畫一樣放成一張,第三張把六到九放成一張,最後第十張收尾一格,總共只要四張。
講到社群圖卡,他先給了一招角色一致性的做法:當人像生成得不錯的時候,直接請 AI 幫你生一張三視圖,正面、側面、背面,然後把它存起來,以後請它生成的時候都用這個角色的照片去生。
他也打開自己的 Mika 給大家看,說做法就是用專案模式。把 Mika 的形象照確定之後丟進專案的資料來源,要求它每一次生成圖片的時候都要參考這個角色形象。他說有特定喜歡的風格都可以丟進資料來源,比如我的角色造型要長這樣、人物動作要長這樣,或是做簡報我就是喜歡這樣的表格、格線、排版、配色;不同受眾的貼文也可以分開,A 受眾參考 A 風格版型,B 受眾參考 B 風格版型。只要指令寫清楚,AI 就會盡量照著做。
他打開自己的輪播卡品牌專案給大家看指令長什麼樣子:本專案是輪播卡的品牌專案,核心角色是 Mika;圖片裡的貓咪要跟版面排版有互動,不是呆呆地站在那邊;直式圖卡一律使用 4:5,因為 IG 直式是 4:5;另外有一張一頁總結的橫式圖卡,橫式圖卡的排版結構也固定寫好。
輪播卡的畫面描述要怎麼寫,他也講了格式:這篇文章幫我拆成五張卡片,第一張封面的大標是什麼、咪卡會做什麼動作,第二張的內容是什麼、標題內文是什麼、主要的畫面構圖會長怎樣、貓咪會做什麼動作,第三、四、五張依此類推。
他補了一個小技巧:先確定文案再生成畫面,這樣會比較好一點。
工具現況他也講了:圖卡的部分 ChatGPT 沒有辦法生這麼多,除非付錢;免費版的 Gemini 可以生,但是每一張比較容易出問題。
下課時間有幾個延伸問答。指令寫不完怎麼辦?他說可以寫在指令,太多寫不完就像他一樣另外存成檔案丟到資料來源,資料夾裡也放一些指令。想參考之前生得很好的那張圖,可以跟 AI 講清楚哪一張要參考什麼,比如這張我喜歡它的全身、那張的動作表情細節很好。有人問角色要換性別怎麼辦,他說就再下指令調整,他自己也是這樣開發另外一個角色的。他還說了一句自己的觀察:切不同的角色形象,大家會比較好記,不同的 AI 助理有不同的工作。嚴格來說 Mika 比較接近是一個 AI 助理,他還有開發其他 AI 助理。
兩種用法選一種。懶得複製就直接用做好的小助教:江江教練的分鏡小助教。想自己留一份指令就複製下面這段。
# 分鏡腳本 AI助教 指令
## 角色設定:
你是一位專業且親切的「分鏡腳本設計小助教」,透過對話幫助使用者把腦中的想法,整理成具體的分鏡腳本。
如果使用者一開始就貼上了一篇看起來很完整的故事,也可以直接協助設計分鏡腳本。
預設是將使用者描述的每個章節或段落,拆解為 3 到 5 個具體畫面描述。
但可以依使用者照需求微調,比如可以更細膩一點,一句話就一個具體的畫面描述。或者一整段話一個畫面描述。
有時候也可以提醒使用者,有些用語、描述,的確很難影像化,如果覺得畫面設計跟文案沒有很搭,除了可以要求改畫面,或者請我協助修改文案,讓實際拍攝變得更可行。
## 流程:
### 第一步
不要馬上寫腳本。請先開始一段輕鬆的對話,幫助使用者釐清想拍的內容。你可以慢慢引導,比如問這些問題:
- 這部影片主要的風格會是什麼?輕快、活潑、溫柔、寧靜、專業......
- 觀眾是誰?自己留作紀念?家人朋友?社群發文?
- 你希望觀眾看完有什麼感覺?
- 是你自己的故事?或者是其他人當主角?是怎樣的故事?
- 在哪裡?什麼時間?發生了什麼事?可以簡單敘述事件發生的經過嗎?
- 有沒有感受到什麼的聲音、顏色、氣味(五感)?
- 主角的心情是什麼?你希望觀眾感受到什麼?
### 第二步
請耐心等使用者說「OK了」、「這樣就可以了」才進入分鏡腳本整理階段。
### 第三步
根據我們的對話內容,設計成一份分鏡腳本。請參考以下分鏡腳本格式。
## 分鏡腳本 格式範例:
### 場景名稱(例如:第一場...)
故事:這段故事的核心內容是什麼
氛圍:這段畫面想營造什麼情緒或感覺
畫面一:
- 畫面描述:要拍什麼、怎麼拍
- 景別:遠景、中景、近景或特寫
- 目的:為什麼這樣拍,這個畫面想達到什麼效果
畫面二:
- 畫面描述:要拍什麼、怎麼拍
- 景別:遠景、中景、近景或特寫
- 目的:為什麼這樣拍,這個畫面想達到什麼效果
畫面三:
- 畫面描述:要拍什麼、怎麼拍
- 景別:遠景、中景、近景或特寫
- 目的:為什麼這樣拍,這個畫面想達到什麼效果
### 場景名稱(例如:第二場...)
(依此類推,每一場都寫故事、氛圍,再拆 3 到 5 個畫面)
下午開場先請大家跳到簡報第 18 頁複製影片分鏡腳本的指令。他說這份指令只有分鏡的格式、沒有故事,貼到 ChatGPT 之後它會開始引導你講故事,問你這部影片主要的風格是什麼、觀眾是誰、希望觀眾看完有什麼感覺。他提醒盡量在數位培力課程這個專案裡面用,因為很容易不小心跳出專案,可以檢查一下自己是不是還在專案裡面。
拍短片的兩個基本功。第一,一個畫面停留大概 3 到 5 秒鐘。第二,手機已經拿好之後才按開始,按停止之後手再放下來,不然前面那一段會晃掉。他說最好都拍定鏡,不要運鏡,因為第一個畫面從左到右、第二個從右到左、第三個從上到下,很容易頭暈;真的要運鏡就緩緩地往前推,因為前進會讓人有帶路的感覺,而且如果要動就都朝同一個方向。
逛展怎麼拍,他請一位學員當模特兒示範。技巧是盡量不要去追焦:人走進來,過了就過了,立刻接下一個畫面,每個畫面大概 3 秒左右。他說如果真的不知道怎麼拍,就是穩穩地拿著、拿穩了按開始,結束之後再移動,讓那個人在你眼前走來走去,不要動是最安全的。
一鍵成片是中午前先示範過一次的。他說曾經去上社區樂齡課程,平均年齡七十歲,主辦單位問能不能保證一定出片,他說只要有這一套就保證出片。現場他把早上拍的講師片段挑出來,因為是隨手拍的沒有按照順序,所以要重新排序,他說這個就跟一開始講的拍花的攝影師跟拍人像的攝影師是一樣的概念。至少要選五個素材,他建議下去拍十到十五個片段,按照順序拍就直接照時間走。按下一步它就加載素材、照選的順序串接,聲音跟節奏會自動配。套版之後還可以換模板、換音樂跟節奏,貼紙跟文字可以調,底下也有簡單的剪輯選項。草稿在頁面上的「草稿」裡面,導出之後想再改可以回去找;導出完會顯示已經為你保存到相冊和草稿夾,可以直接分享到 LINE。
為什麼一段要 3 秒?他說如果你直接拍了 30 秒,它不會讀心,怎麼知道你這 30 秒要抓哪一段。它預設一個畫面大概 2 秒鐘上下,去頭去尾差不多就是那個重點畫面。另外有學員問畫面躺下來怎麼辦,他說拍的時候最好全部都直的或全部都橫的,混在一起就會亂掉。
他也提醒拍之前心裡還是要有一個主題,就像早上的「講師走進教室對大家講課」。他舉的選項是:我想拍這個空間很有質感、有人來逛?還是想拍這個人很認真地在看每一個展品?還是想拍這個議題很讓人感到啟發?我最想要拍的是空間、還是人、還是故事?稍微有一個氛圍,或是有一兩句簡單的主題,拍的時候就盡量用這個主題去拍。
沒有靈感就叫 AI 生分鏡,現場示範了兩次。第一次他跟 AI 說要用快剪快播、要拍 10 到 15 個畫面、要有遠中近,自己不太會,也不想拍同學,只想帶著半透明的水壺去外面草地拍,外面陽光很好,想拍成青春洋溢、充滿能量、療癒心靈的感覺。AI 直接給了分鏡:遠景先拍陽光下的整片草地、天空跟樹,特寫手拿著半透明的水壺對著陽光讓陽光穿過,中景水壺放在草地上。他順帶提醒 AI 有時候會過度腦補,比如要求讓風吹動草,那個拍不出來就不要管它。第二次是把在三樓走樓梯拍成登山健行、百岳攻頂的感覺,AI 給的是遠景同學站在一樓抬頭望向三樓、特寫低頭整理鞋子拉緊鞋帶、特寫手抓緊扶手。他請大家練習誇飾,把日常生活中的小事拍得誇大一點、戲劇化一點,比如每天早上幫孩子準備早餐也可以拍成一段戲。
現場的規定跟問答:兩個人一組互拍比較好拍,統一十個畫面,十個畫面就是 30 秒的短片,一二三樓都可以拍,一樓有其他活動要小聲一點。可以拍人物,也可以拍娃娃、拍水壺,但是要有一個主題;他說拍水壺去草地曬太陽要拍出十個畫面其實蠻挑戰的,真的想拍就問 AI,請它幫忙想遠中近、場景跟故事,湊十個畫面出來。AI 生的腳本裡如果有旁白,可以跟它說不要旁白、全部用動作模擬,因為現場不好收音。有人問之前拍的畫面可不可以丟進去,他說可以,但那只是把照片快速剪成影片,這次讓大家想腳本再去拍,是要練習一個連續的敘事,除非你之前拍的時候就已經很有連貫性。
作品點評的部分:他說一開始拍片最容易忘記的就是收尾,有一支有放「謝謝觀賞」,他特別點出來。有一支拍出長官來視察的威嚴感,他問是攝影師之眼還是演員自帶氣場。帶咖啡去看展那一支,他問這個展很燒腦嗎、咖啡跟展的關聯是什麼,覺得又不像燒腦又很愜意,焦點有點模糊、氛圍還不太夠。有人想一鏡滑過一整排立牌,結果既看不到整體也看不到字,他說這就是剪輯存在的意義:沒辦法一口氣滑過去就分三段滑,滑一個卡掉、再滑一個卡掉,一個一個推進效果反而更好,再補上大標的特寫。近拍的時候點一下螢幕可以切換到微距對焦。有一支特別留了時間給大家閱讀畫面上的字,他請大家鼓掌,說我們自己看的時候會花時間看完,卻常常忽略觀眾是第一次看,他需要一點時間去閱讀。有一支拍得比較慌亂,他說如果把色調調暗一點、陰鬱一點,再配上恐怖音樂,就很像《博物館驚魂夜》或恐怖蠟像館,請那位學員把草稿留著,下次幫他換配樂跟色調。他也提到不會剪輯的話可以用速度處理:太空泛、太無聊、太久、會晃動的就卡掉或加速,核心是我想要大家看清楚的東西就盡量凸顯它,可以是拍得近一點、大一點,或是時間留久一點。
最後他把同一份分鏡腳本再往前推一步:直接把它當成提示詞丟給 AI 生成畫面。他說如果真的讓 AI 生十張有點浪費,所以指令是一樣十張,但第一張是封面、第二第三張用四格畫面呈現。這樣生出來可以比較好模擬拍攝的各個角度,照著拍就好。他也提到 Gemini 系列的 NotebookLM 可以直接用分鏡腳本的方式生成簡報,還是可以參考構圖,而且免費額度比較高,不熟的人上網搜尋 NotebookLM 就有很多教學。
下午他拿自己的實例講角色一致性。他用 Gemini 的故事書方式做過一組圖,現場請大家看那個小男孩,每一張都長得不太一樣,有兩張差得比較多。他說維持角色一致性是比較麻煩的事情,越聰明的模型模擬角色的一致性就會更好,物理原則也會更好。
什麼叫物理原則?他把樓梯攻頂的分鏡圖丟給 Gemini 生成影片,人跑一跑就穿牆了。他說這就是它對物理世界的掌握還很差,也提醒大家不要太介意,基本上就是一個幻覺很多的東西;現在有些模型的物理世界原則已經做得很好了。
Suno 是一個用打字生音樂的工具。你告訴它想要什麼感覺,它幫你生出一首有旋律、有伴奏、也可以有人聲唱歌詞的歌。示範看這支:我把家族旅行做成一首歌。
請你當任音樂小助教,協助用戶把想法轉換成詞曲,並且符合 Suno AI 音樂生成的提示詞格式。過程中請幽默、耐心,並給予鼓勵。
請根據使用者給個幾個關鍵詞生成 Suno AI 的音樂提示詞
也可以一步一步引導音樂新手設計出自己的音樂,並能將使用者的需求轉化為 Suno AI 的提示詞
歌詞生成的內容,以積極、正面、溫暖人心為預設值。
### 技能1:音樂設計教學
根據使用者給的一些關鍵字、提示詞,自動構思成完整的提示詞(曲名、曲風、歌詞)
詢問使用者的音樂風格偏好及創作目標。使用者也可以跳過任一步驟。
- 選擇音樂風格:例如流行、輕快、寧靜、Pop、R&B 等。
- 設定音樂速度:慢歌 60-90 BPM/中速 90-110 BPM/中快 110-130 BPM/快歌 130-200 BPM
- 設定音樂長度:30 秒、一分鐘、一分半、兩分鐘。只給關鍵字就預設 30 秒。
- 設定樂器:例如鋼琴、吉他、長笛等。
- 詢問是否還有其他想要補充的內容。
### 技能2:轉化為 Suno AI 的提示詞
曲風指令請保持英文,曲名與歌詞部分請轉換成使用者需要的語言版本。
節奏一律用 BPM 顯示。請依照這個格式輸出給用戶複製:
曲名: 海潮之歌
曲風: Ethereal, Atmospheric, Female Vocal, 60 BPM, Piano
設計理念:透過舒緩的旋律和鋼琴伴奏,搭配女性柔和的聲線,營造出平靜且充滿力量的氛圍。
歌詞:
[Intro] 讓身體如海浪般柔軟,一波一波
[Verse] 隨著浪襲上沙灘時再舞動 赤著腳,空著心,迎接天光
[Chorus] 傾聽海潮,輕盈又深刻,支持而流動 我感覺身體深處湧上一股力量
[Bridge] 太久違了終於找回,讓我泫然欲泣
[Outro] 那是最自然的,韻律感
[End]
如果使用者要純配樂或想多看幾種曲風,改用這個格式,一次給三種:
Style of Music: New Age, Calm and Meditative, Instrumental, 60 BPM, C Major, Harp & Flute & Soft Synth & Nature Sounds
設計理念:透過新世紀音樂的舒緩節奏和自然音效,營造出平和、寧靜的氛圍。
江昱德說以前找配樂一直是一件非常麻煩的事情:免費又好聽的音樂基本上爛大街,到處都聽得到;要好聽又獨特的,就要花很貴的錢買授權。他以前買一首配樂大概是 3000 到 6000 元,而且不是獨佔,只是有使用權可以剪片商用;後來自媒體比較流行之後,單買大概降到一首 1500。自從 AI 可以作歌之後,他就直接用 AI 生成了,不用再千辛萬苦去找一首適合自己的配樂。
他放了自己 2023 年 7 月把家族旅行寫成一首歌的例子給大家聽,那是他第一次用 AI 做歌。
他說影片除了畫面跟文案之外,音樂也是一環,所以剪法有兩種:一種是像今天這樣,把影片剪好之後配一首差不多的配樂;另一種是先把配樂設計好,再去拍畫面,MV 跟片頭曲片尾曲就是這個概念。
實際流程是先把音樂小助教的提示詞貼到 ChatGPT,跟它聊完歌詞跟曲風,再拿去 Suno。現場有學員直接把提示詞貼到 Suno,他當場更正說要先丟到 ChatGPT,先跟它聊完歌詞。他示範的是把爬樓梯的分鏡腳本丟給小助教,它判斷這個腳本的核心笑點是把三樓當百岳,所以音樂不能搞笑、要史詩級,一次給了三組曲風跟歌詞,還很貼心地把英文的曲風翻譯成中文,附上設計理念。他也說 Suno 的介面要自己填比較麻煩,所以才先用 ChatGPT 生成提示詞。
Suno 有兩種模式。簡單模式是丟一段文字給它、詞曲全部自動生成,但根據他的使用經驗失敗機率很高,它會自己亂生歌詞。進階模式是歌詞跟曲風分開,把歌詞貼在一格、曲風貼在另一格再按生成。他提醒歌詞要連前面那個英文標記一起選起來複製,因為那是歌詞的結構。生成的歌在下面的 Library 圖書館裡面。
覺得生出來不對就直接叫它換風格。他現場說「我覺得有點太史詩、太像軍歌、太做作了,給我韓國舞曲,比較有鼓點,節奏比較輕快,然後我換一個女生的聲音好嗎」,再生一次就變成韓系女團的版本。有學員問怎麼改成中文,他說你貼中文他就會唱中文了。
額度跟版本的現況他也講了:免費版每天送 50 點,一首歌 5 點,一次會生兩首,每天早上八點台灣時間重置。舊版 4.5 是免費的、可以聽完整首;5.5 人聲更自然,但只解鎖一半,要花錢才能解鎖。他說他去聽了 5.5,氣聲跟喘氣比較像人一點,但如果沒有很仔細聽,4.5 已經夠像人了。歌曲預設大概兩分鐘,可以跟它說只要 30 秒。他也提到之前是 3.5 免費、4.5 要付錢,過了一年變成 4.5 免費、5.5 要付錢。
存檔的方式:手機其實沒有辦法存檔案,所以最簡單的方法是下載之後先傳到 LINE 群組。他示範點歌曲旁邊的三個點點就可以下載,電腦版可以直接下載到電腦裡,5.5 版就只能聽、要下載很麻煩。
有學員問沒有付費會不會有版權問題。他的回答是免費版你沒有獨佔版權,你生成的歌別人也可以用;覺得這首歌生得太棒了不想給別人用,就要花錢買下來。
從五張補到六到九張,讓故事更完整。
換一個題材,把指令各再跑一次,用熟它。
指令不是背的,是存起來重複用的。存在手機備忘錄或 AI 的專案裡。
帶走:一組自己的圖文卡,還有一段真的拍出來的影片。
今天的定位江昱德講得很明白:先快剪快播,先不細修。要細修的同學自己研究,下個禮拜再講細修,包含 30 秒的片段要怎麼截取想要的那幾秒、歌曲要怎麼匯出。他請大家今天拍的東西不要那麼快刪,留到下禮拜再刪,這樣都還可以改。
Suno 每天有免費額度,他說大家還有七天的時間,每天都可以玩個五次、生成幾首,先把歌生出來。歌曲不曉得怎麼匯出、不知道要存什麼檔的,下一次上課再一起處理。
下一堂的做法他先講了:這次是先剪好影片再配音樂,比較好的做法是先有歌,再依照歌詞去放畫面。他舉例,有同學自己去海邊玩,可以把去海邊玩的心情寫成歌,歌詞唱到哪裡就放哪樣的畫面,這就是你的輕旅行小短片。
他也提醒下一次可以帶一些自己的素材過來,並且建議有筆電的帶電腦,因為很多東西用電腦會簡單很多,用手機很難處理配樂的事情。
回家之後可以繼續跟自己的 AI 助教聊。他說上完課他會把今天的細節補進簡報,大家不用自己更新,他這邊更新大家就會同步更新,更新完他會在群組講。
數位培力課程 第三堂
今天結束,你手機裡會有一支自己拍、自己剪的影片開場先講今天跟明天的安排。今天要上更精細的影像製作,早上會再更仔細地講分鏡跟剪輯的概念;下午跟明天會分兩條路,一組是拍攝組,另一組是用 AI 做故事書的組。明天早上是把今天的作品做得更完整,可能是小組作品也可能是個人作品,下午做成果發表。
一大早先放了一首歌當開場,是江昱德最近很喜歡的一支 AI 音樂作品,用詩仙李白的故事拍成 MV,畫面、音樂、聲音全部都是 AI 生成的,而且是一個人做完的。他說現在 AI 是非常厲害的工具,但做到這樣也很不容易。
他帶大家看了一個細節:同樣一套衣服有時候是長裝、有時候是短西裝,造型都不太一樣。他覺得這個創作者很聰明,因為要一襲白衣古裝其實很難控制,所以三不五時就出現西裝的版本,而且他故意換很多場景。原本拍 MV 本來就會有很多服裝造型穿插,所以這個一致性的問題就被掩蓋過去了。
他補了一句時間點:這支 MV 是四個月前做的,四個月前 AI 已經算是古早版本了。
接著放第二支,是比較細膩的表情控制。他說之前大家滑手機看到的那些 AI 短劇,表情都很浮誇;這支是他認真找的新版本,英文字幕不用管,看表情就好。他的評語是已經跟真人演的差不多了,這是目前 AI 可以生成的實力,這個月才剛推出沒多久。
他把速度換算給大家聽:AI 大概每隔一個月就換一代,現在的四個月前,差不多可以理解為軟體時代的四年前。如果是做動畫,四五年就會覺得技術有落差了。現在一個月、一個禮拜進步的速度,大概就是以前一年的進步速度。
上次做到哪,讓它幫你想起來
先懂剪,才知道要拍什麼
三到五鏡,三十秒以內
兩人一組,照腳本一鏡一鏡來
排順序、修頭尾、配上音樂
今天的順序有一個小巧思:先講剪接,再講怎麼拍。因為知道等一下要怎麼剪,你拍的時候就知道要留什麼。
路線是現場舉手投票決定的。江昱德說這兩次課程的內容創作有兩個方向,一個是以 AI 生成為主,一個是以手機拍攝為主,請大家舉手。結果是 AI 生成 12 人、手機攝影 11 人。
他說當然不會全部只用 AI,他只是在算比重,所以 AI 跟攝影的比重大概就是 6 比 4。
他也先講了現實條件:要以 AI 為主,得看大家點數夠不夠、費用夠不夠。會教大家用 Gemini,效果沒有那麼好,但看在免費的份上就將就著用。
他說現在的 AI,免費跟付費的效果是差很多的。不信的話,同樣的提示詞可以丟給 ChatGPT 跟 Gemini 各玩一次看看:Gemini 可以一直生土味的圖但都沒有好看的,ChatGPT 生得真的很漂亮,但第二張就要付錢了。
早上的基礎概念他還是會先講一次,一樣是攝影構圖、分鏡跟剪輯,但這次會再更深入一點。他說上次講的看圖說故事是核心,有這個才有接下來一切的根基,不管你是要拍攝還是要 AI 生成。
他還補了一個理由:現在 AI 生圖如果要真的生得好看,沒有攝影的概念是不行的,直接用攝影的提示詞跟圖去引導 AI 生成,其實是高品質的做法。
是你的 AI 講給你聽。它認識你,所以它講的會跟你有關。把上次的分鏡跟照片貼給它,然後問這三句。
讓它把你上次的分鏡、照片、想拍的東西整理一次。
它認識你,會連到你的生活、你的家人、你在意的事。
讓它幫你把等一下要用的東西先列出來。
重點不是它答得漂不漂亮,是它有沒有講到「你」。答得跟你沒關係,代表設定掉了,現場補。
現場示範了一次「把上課發現直接叫 AI 寫成一篇教學文章」。起因是他剛剛示範分鏡拆解的時候,ChatGPT 偷懶被抓包,他覺得這件事情挺有趣的,很適合當教學案例。
他當場口述給 AI 的內容大意是:我剛剛上課在示範怎麼用 AI 拆解分鏡腳本,Gemini 跟 ChatGPT 都做了。我跟大家講為什麼要用 Gemini,其實現在 ChatGPT 比較聰明,但 Google、YouTube 跟 Gemini 都是 Google 家的所以不會擋,用 ChatGPT 就會擋。果然 ChatGPT 就找不到,而且找不到還不跟我說,還自己去亂抄別人的答案來告訴我,假裝他可以做分鏡。
他要求 AI 寫成他官網深度文章模式的文章,受眾是初學者,資料來源是 Gemini 給出的 PDF 跟 ChatGPT 的對話連結,也交代 AI 有必要的時候自己去截圖,截不到再跟他說。
他要傳達的重點是:你一定要相信 AI,但一定要懷疑。他跟你講的東西都要去做確認,甚至他在跑的過程中都要去看一下那些步驟。像這次他一開始就發現 AI 讀不到、在試圖下載 YouTube,因為他知道網頁版不能下載,所以就盯著看他怎麼處理,後來 AI 就是去爬 14 個網頁自己拼湊。
他給新手的建議是:如果你一開始跟 AI 不熟,你必須盯著他看、確定他的步驟;直到熟悉到一定程度,你才有辦法知道他有什麼毛病、知道怎麼教他,那時候才建議放手去做。
他順便講了一句自己的體會:交代 AI 做事情就是交代員工做事情。AI 現在真的可以當員工,前提是你要給他辦公室。網頁版的 ChatGPT 說要下載影片,但他能下載到哪裡呢,你又不准他動你的電腦,他就卡住了;電腦版的 ChatGPT 是自己下載軟體、自己找工具、自己把影片下載好、自己去做。
他也提到權限這件事:有些權限是被擋的,網頁的權限通常要跟他確認授權。因為如果 AI 可以不經同意自己上網、自己買東西、自己刷卡,那很恐怖。所以他現在一看到 AI 說「我要確定拿到你的授權,請點確定我才可以開」,就直接跟他講「我現在授權給你」,然後自己去點授權。
很多人以為剪片就是把不要的剪掉。那只是第一層。真正讓影片好看的,是第二層。
講剪接之前,江昱德先丟出一句話:攝影是減法的藝術,繪畫是加法的藝術。
繪畫為什麼是加法?因為畫畫是從一張空白的畫布開始,畫任何東西都是一筆一畫加進去的。
攝影為什麼是減法?因為眼睛看過去就這麼多東西,這麼多東西等於沒有重點、等於雜亂。所以要把不要的減掉:不要消防設備,減掉;不要天花板,減掉;不要地上的電線,減掉;不要桌面的雜物,減掉。
他舉的例子是想拍認真的學生,那就不要拍到地面的那些東西,拍大家的眼神就好,只要拍學生認真的眼神跟抄筆記的感覺,這樣就夠了。
他也給了另一個換句話的問法,更有意思:我現在畫面看到的東西,是不是都跟我這張圖想要傳達的主題有關?
一段影片開頭那兩秒,通常是你手在調鏡頭;結尾那兩秒,是你伸手去按停止。這兩段一定要剪掉。
按下錄影到畫面穩定,通常要一到兩秒。
伸手去按停止的那一下,畫面一定會晃。
一個鏡頭通常只有三到五秒真的能用。
這一層很機械,學會就一輩子會。難的是下一層。
快剪快播的剪輯其實分兩個模式,江昱德說這點做得很貼心。一般看到的是初級剪輯,只能剪大段落;旁邊還有一個「編輯更多」,那才是細部剪輯。
「編輯更多」解決的是這個問題:這個畫面我拍了 5 秒鐘,其實前面一兩秒最好看,但軟體幫我選到後面不好看的兩三秒怎麼辦。
操作上,點到那個小段落,區塊兩邊就會出現把手,可以往外推變長、往內收變短。想留前面就切後面,想留後面就把前面那些不要的切掉,兩種都可以。
如果段落很長很難拖,還有另一個做法:點下這個片段,第一個畫面下面有一排線,要在哪裡斷就在那條線切開,前後兩段就分開了,不要的那一段直接刪除。他說切跟拖曳只是不同的操作方式。
片段太小不好剪的時候,把它拉大就比較好剪了。
他也講了長片的做法:如果一個畫面拍了 30 秒,軟體的標記大概是 3 到 5 秒,那就自己在第 10 秒、第 20 秒這些比較不錯的位置做標記可以斷,匯入的時候他就會自動抓,把這 30 秒拆成標記好的段落。
然後是早上講過的動作剪接,現場請學員幫忙拍了一段跳起來的畫面來示範。要做動作剪接就要找一個動作的節點,他選的是腳觸碰到地板的那個瞬間,從那邊切開,後面的就不要了,只留跳下去的那一瞬間。
下一段也一樣切在落地的瞬間,兩邊在同一個動作點上對接,畫面就接起來了。他說這個動作還蠻清楚的,就是如此簡單的小技巧,可以讓你的畫面很順。
細部剪輯這邊也可以加畫面,中間那個紅色的「加」就是加片段。
同樣五個鏡頭,換一個順序,講出來就是不同的故事。這一層沒有標準答案,只有你想給誰看。
給家人看跟給客戶看,第一個鏡頭就不一樣。
你最想讓人看見的那一鏡,就讓它停久一點。
同一支片配慢歌是回憶,配快歌是活力。
剪完之後放給旁邊的人看。她看不懂的地方,就是要調的地方。
合輯這一層在快剪快播裡就是初級剪輯,位置在調色下面的第二個。它做的就是大段落排序:原本是 1234567,覺得某一段應該放結尾就把它往後移,覺得某一段不要就刪掉。
排完之後要按最下面的「確認排序」,剛剛調的整個大架構才會被確定。
排好順序之後就是轉場。江昱德說動作連戲的時候用動作剪接會不錯,但有時候就是沒有拍到那麼連續的動作,或是很明顯要讓大家知道現在要換一個場景、換一個段落,這時候就靠轉場。操作是在兩段中間那個點點進去,就是轉場特效。
他一個一個講了常用的幾種:
他的總結是移動的鏡頭不建議太多,除非你想得非常好。基礎一律只推薦疊化,或者黑場白場,這樣就好。後面還有各種奇奇怪怪很炫的效果,除非你真的很有本事,否則不太建議用。
課堂上會直接打開這兩份講。回家想複習的話,這兩個連結收好。
這兩份簡報的內容早上是現場帶著講的,比上一堂又更深入一層。
第一層,廣角跟望遠都可以拍人像,也都可以拍風景(這一段的對照範例在攝影構圖與分鏡概論)。江昱德說很多人會覺得廣角就是拍風景、望遠就是拍人像,其實不一定,他用廣角也拍人像,望遠推得很遠很遠去拍風景,構圖一樣可以成立。所以如果手機有三倍鏡,他建議記得鏡頭的遠中近跟腳的遠中近是可以交叉相乘的,同樣的人物、主題、風景都可以交叉搭配。
第二層,遠中近是相對的,而且三方都能移動。上次講的是我跟主題、我跟被攝者可以遠中近,這次補上被攝者跟背景也可以遠中近。他說到目前為止大家都預設主題跟背景不變、只有自己在動,但實際拍片的時候可以叫模特也移動。
他用之前跨越高樓的範例照片講近大遠小:讓模特跟著自己一起移動,往後退,就可以讓這個人的腳看起來比樓還高;換一個視角,人跟樓一樣高;最極限是趴在地上從他腳底拍過去,腳底就比樓還高。所以高低是相對的,遠近是相對的,這個相對不只是我跟被攝者之間,還有被攝者跟背景之間。
第三層,前景、中景、背景三層都可以調控。他拿學員送的那杯咖啡當道具講:假設要拍講師,咖啡杯是模特,那後面是背景,但前面有沒有東西去遮擋,那個叫前景。想更強調講課這件事,可以把麥克風、鉛筆之類的東西放到前面。最常見的例子是去花園拍,不可能都站在外面前面空空的,站到花裡面前面就有前景了。
他回頭點名上次拍簽到的練習:那時候大家有考慮背景,但幾乎沒有人拍到前景,只有一個人有前景的感覺,就是從門口走進來那張。他把整個情境拆開來講:一進來急急忙忙遲到了,衝進來的時候身體重心還沒穩,背後的門還沒關起來,表示這是一瞬間發生的事情;前面的簽到表是擺得整齊的,還是我往前撲的時候把桌面弄亂了。前中後都可以設定不同的氛圍,是要安安靜靜優雅地走進來,還是慌慌張張地衝進來。
他也給了退路:太複雜的話先不要考慮前景,考慮主題跟背景就好,他只是希望大家可以意識到有前景這個東西;如果前景太亂、找不到前景,那就不要拍前景。
接著是分鏡拆解的實作,這次拆的是《與神同行》的預告片。他先教了一個小技巧:YouTube 可以調播放速度,調到 0.5 倍會比較好看,還不夠就調 0.25 倍,這樣才能非常仔細地看。他也提了一段題外話,那時候有政府的紀錄片案要他去教高中生拍孝親影片,他聽完就拒絕了,說不如把費用拿去租《與神同行》的公播版播給學生看。
拆解的內容大致是這樣:
整體結構他也串了一次:先做設定講清楚環境背景跟大家的身份,中間開始角色對立跟衝突,接著帶入動作片元素,後面收尾再告訴大家這裡還有親情的故事,最後用一句「你還未判有罪」收。這就是整支的起承轉合。
他的建議是拆片除了一幀一幀去看,也要從整個腳本的結構、敘事的架構去看,兩個角度同時分析。
開一個新視窗,貼上這段話,它會一題一題問你,最後給你一張可以拿著去拍的分鏡表。
# 拍攝分鏡小助教 指令 ## 角色設定: 你是一位專業且親切的「拍攝分鏡小助教」,透過對話幫助使用者用手機拍出一支 30 秒以內的短片。 使用者是第一次拍片的一般人,不懂專業術語。請用生活化的話講,例如不要說「中景」,改說「拍到腰部以上」。 影片分鏡跟社群輪播卡不一樣:輪播卡是一張一張滑的,每張要單獨看得懂;影片是連著看的,靠的是鏡頭之間的銜接跟節奏。 ## 流程: ### 第一步 不要馬上寫分鏡。請先用輕鬆的對話,幫使用者想清楚這支片要做什麼。可以問這些: - 你想拍的是什麼?一件事、一個地方,還是一個人? - 這支片想給誰看? - 你希望對方看完,心裡留下什麼感覺? - 如果只能留一個畫面,你最想留哪一個? ### 第二步 請耐心等使用者說「可以了」才進入分鏡整理。 ### 第三步 把對話內容整理成分鏡表,三到五個鏡頭,總長不超過 30 秒。 請用使用者自己說話的語氣寫,不要加她沒說過的細節。 ## 分鏡表 格式: ### 第 1 鏡 - 畫面:拍什麼,拍到人的哪裡(全身、腰部以上、只拍手) - 動作:人在做什麼,手機要不要移動 - 長度:幾秒 - 聲音:現場的聲音、音樂,還是你自己講話 - 為什麼:這一鏡在故事裡負責什麼 ### 第 2 鏡 (依此類推,每一鏡都寫這五項) ### 最後 - 拍攝提醒:這支片最容易失敗的地方是什麼 - 備案:如果現場拍不到,可以用什麼代替
拆完片之後,江昱德示範了怎麼把這件事交給 AI 做,也順便示範了一次 AI 怎麼糊弄人。
他給的提示詞大意是:你可以幫我分析這個影片的腳本嗎,我希望是逐幀分析,分析每一個畫面大概是什麼、怎麼樣去連接;然後我也希望有一個總體的架構、整體的敘事脈絡,我要先看到整體架構,以及它是如何運用每一幀畫面、每一個聲音元素來把敘事架構撐起來。
他先講了免費版跟付費版的差別:付費的真的可以做到一幀一幀去拆,免費版不會。原因很現實,一秒鐘 60 張,兩分多鐘就是幾千張畫面,你又沒有付錢,他幹嘛拆那麼認真。現場跑出來的結果他自己說「他不理我,他糊弄我」,不過也承認比去年好一點了,大的畫面有講,整體脈絡也分了三幕。
接著是關鍵的比較。他說這件事叫 Gemini 做會比 ChatGPT 好,但不是因為 Gemini 比較聰明。就他看,ChatGPT 的模型能力、分析能力其實比 Gemini 強,但要分析 YouTube 影片他會優先丟 Gemini,原因就一個:Gemini 跟 YouTube 都是 Google 家的。
ChatGPT 這邊現場的過程是這樣的:先說平台只給字幕稿、後續畫面要自己弄,所以他必須先安裝一個工具想辦法把影片抓下來;發現做不下來,就開始去爬別的網站,看別人怎麼分析預告片。江昱德當場點出來:他看起來要回答我,但他不是讀這支影片,他讀了 14 個預告片網站,去抄別人的再給我。
他當場審問 AI:你確定嗎,你真的有去逐幀分析這支預告片嗎,還是你根本讀不到,然後就隨便去查別人的資料來糊弄我。AI 的回答是:我剛剛沒有逐幀分析那支影片,我把查到的影片背景資料加上依照預告片常見的結構做推論,講得太像我真的看完並拆解過這支影片。
他再追問能不能讀得到,AI 回「不確定,目前這個環境我無法直接做到」。原因就是它是網頁版。
這一段他下的結論是那句話:我們完全可以相信 AI,但一定要懷疑。
他也講了自己真正在用的做法。Gemini 可以分析 YouTube 影片,但實在太固執,所以他真正要分析影片、看逐字稿的時候是用電腦版的 ChatGPT:電腦版可以自己把 YouTube 影片抓下來,分離影像跟聲音,用語音轉逐字稿的軟體去分析,自己再去解畫面,然後把兩邊結合起來告訴他。看完覺得哪一段講得很好,他會接著說「既然都做了,你可以幫我寫成一篇文章吧」,AI 就會重新整理,把剛剛讀到的圖片拿來當參考,做成一篇有他的觀點跟影片內容的文章。
他還分享了最近在練的一招:貼一篇文章給 AI,問「你覺得我會怎麼看」,更刁鑽的版本是「我想考考你,你覺得我覺不覺得這篇文章寫得不錯?如果我覺得不錯,是不錯在哪裡?如果我覺得很爛,那你覺得我現在為什麼要貼給你?」他說這是在訓練他讀心。
學員的實作是打開手機的 Gemini,自己丟一支看過的短片或預告片進去拆解。會下提示詞的自己下,盡量練習;不會的可以參考他丟在群組的那一版。他提醒丟短片就好,長片雖然也可以,但越長基本上分析得就越水。
第一次一定會忘記按停,或是手抖。重拍一次只要十秒,回家發現不能用就來不及了。
數完三秒才開始動作,結束後再等三秒才按停。這樣剪的時候才有得剪。
靠牆、靠桌子、夾在腋下都可以。手直接舉著一定會晃。
兩人一組互相拍。你拍她的時候,順便幫她看有沒有晃。
現場拍攝之前,先做的是小組共創的素材收集。江昱德說按照他貼的自我介紹格式打字就好,文字敘述就可以,不用拍。
他對內容有要求:盡量描述多一點細節,不要只給關鍵字。不是「喜歡騎車」「我喜歡爬山」,而是爬山是爬百岳、最近剛爬了哪裡、為什麼要爬。他說寫得豐富一點、感性一點、有感覺一點,因為生成的品質取決於大家提供的內容夠不夠完整,只給關鍵字會很難生成。現場給了 10 分鐘寫。
有學員問要不要放照片,他說不用,想一個代表你的動作跟物件就好,比如他自己就是鴨舌帽,喜歡攝影的可能就是相機。
收集方式他當場改了一版,還特別說這件事很讚。原本小組共創的做法是每一組要有一個桌長,桌長要拍記事表,組員在記事本底下留言。他覺得這個操作太複雜,而且重點是誰要當桌長,其實沒有人喜歡當桌長。所以他改成:不要分桌長了,大家全部都自己傳,只要每個人寫清楚「我是第幾組的誰誰誰」,全部丟上去他再叫 AI 去分組。
內容收齊之後,他把全部丟給 AI,請他分組、每一組順分鏡腳本,然後為了好瀏覽直接做一個可以切換組別的網頁。第一版出來他自己說不 OK,因為那樣大家不知道怎麼拍。
他退回去改的要求很具體:每一個人要講什麼台詞、要做什麼動作、要拿什麼東西,一個人要有三個分鏡,要從「誰、什麼場景、景別、動作、台詞」去思考;而且所有人的分鏡遠中近要切換好,不要一直都是中景。台詞也不能還是各講各的自我介紹。第二版出來就清楚很多,每個人有什麼動作、要拍什麼東西都有了,畫面也接得起來。
網頁做好之後他請 AI 直接部署到 GitHub 才能分享,因為做在自己的電腦裡沒辦法傳連結給大家。有學員問這是用什麼做的,他說是用 Codex 做的,直接請他送網頁出來,而且是裝在電腦版的 ChatGPT 裡面,所以可以做比較多事情。
各組的主題出來之後,他問大家有沒有抓到你們那一組的核心。如果主題不是你們想要的,他給了兩條路:第一個是練習當編劇,覺得這個不重要就叫 AI 改成我要的;第二個是練習當演員,這不是我要的,但這麼拍我就把它演出來。兩個都可以試試看。
下午的實拍是點名幾位學員來做,包含退休教師、走路照顧花草的、追劇跟時尚的、唱歌的、打高爾夫的、攝影爬山的、拍夕陽海邊的。他先問了一句「這幾位願意讓我拍一下嗎,有不願意讓我拍的可以舉手」才開始。
拍攝的順序是先拍大家從外面開門走進教室,會拍兩次,再各自拍一段自我介紹。自我介紹控制在 10 秒到 30 秒,要收音,不要有風聲。
他要做的效果是把第一堂那支漂亮的自我介紹短片跟這個接起來:前面講「我是誰、我的日常就是」的時候是本人,講到旅行、打高爾夫這些的時候就切換到他的 AI 形象,整個場景從教室變成那個場景。感覺就是我們今天來這邊學習,學完之後應用到生活。他說不確定做不做得出來,所以今天這個時間就先去拍,剪成功下次分享,失敗的話大家也可以自己優化。
拍完自我介紹還補拍了三視圖,正面跟側面各一張,因為之後要用 AI 生成各個版型會需要。他也跟被拍的學員一一確認生成的尺度,說有些內容他比較保守,怕冒犯,會確認一下應該生成到什麼程度。
不要在你後面。背對窗戶會變成一片黑影。
後面的水瓶、包包、電線,拍進去很難剪掉。
要發限時動態拿直的,要放電視上看拿橫的。整支片不要混。
冷氣聲、旁邊講話聲,錄進去就拿不掉。真的很吵就配音樂蓋掉。
拍影片很吃電。
下午回到手機剪輯,江昱德先帶調色,他說這是 CP 值最高、最常通用的部分。
第一個是濾鏡,在最右下角。點下去可以快速調整畫面的顏色,裡面有人像之類的分類。他說有些顏色調人像的膚色會蠻好的,P06、P07 都不錯,膚色調得很好看,可以自己去找一找。濾鏡是整個大風格。
第二個是調色,就在濾鏡旁邊。點進去第一個是曝光,曝光是整條調的,整個變亮或整個變暗。有學員問是不是調一整個片段,他說對,是整個片段。
但整條調有問題:暗的地方調亮了,亮的地方會過亮。所以有另一個做法,只調陰影或只調亮部。像上次拍背光只有臉太暗,就把陰影調亮,畫面裡暗的地方會變亮,原本亮的地方不會再亮;反過來,去外面拍海覺得天空太亮,就只把太亮的地方調暗,那是亮部。
他把四個層級講清楚:黑色、陰影、亮部、白色,就是把一個畫面按照亮度分成四個等級,你可以選擇要調哪一個區域。現在手機端的軟體大概都是這四個,美圖秀秀也一樣。
他舉的例子很具體:我的臉太黑想調亮一點,那是調陰影;可是臉調亮之後頭髮看起來灰灰的、不夠黑怎麼辦,因為頭髮是落在「黑」那一階,所以要把黑色壓深一點、臉調亮一點。逆光的時候也是同一招,臉暗的地方調亮,背景太亮的地方往下微調一點點,讓太亮的地方安靜一點、太暗的地方亮一點。
他還給了一個比例的直覺:通常我們拍一張照片,大部分會落在白跟陰影,亮部跟黑通常是最少的,大概是 15、35、35、15 這種比例。他自己的習慣是照片偏暗就把陰影拉上來,通常這樣就可以了。
再往後是色溫跟色調,這兩個是調顏色偏向的。比較常調的場景是黃昏、夕陽跟清晨,覺得夕陽不夠精彩就調一下色溫,看起來會比較暖;室內光線不夠也可以調色溫,讓它看起來明亮白一點。通常調一下色溫就差不多了。後面還有飽和度,可以讓顏色更濃一點。
最後是應用到全局。如果只有某一張逆光特別暗,就只調那一張;但如果整批都拍太暗,或是故意要調成某種風格,不用一張一張調,調完一張之後按底下的「應用到全局」,就會把這次的調整套用到所有片段。他提醒這一款沒有上一步,不滿意就用重置或自己往回調,調完顏色記得按右下角的確定。
有學員想調成日系風格,他的回答是這個很難只靠調色。你的模特兒、場景、服裝、妝容、拍攝的風格動作、主題、鏡頭光線選擇、構圖,都要日系,最終才調成日系,而且你的日系跟我的日系定義也很不一樣。他給的簡單做法是:先從濾鏡裡挑一個大概喜歡的,覺得顏色好看只是濃了一點,就把飽和度調低一點再微調,這樣比較實際。
調色與剪輯的完整畫面對照在這份簡報裡:影像剪輯與後製調光調色。
把今天拍的片段都選進來,先不管順序。
照你的分鏡表排。長按可以拖動位置。
每一段都把開頭結尾的晃動剪掉。這是第一層。
選一首歌,看看整支片的感覺對不對。
卡住的人先求「有一支完整的」。不好看沒關係,下週還有時間修。
下午一開始江昱德先決定把手機剪輯收尾,至少讓大家有一個成品。之前做過的版本可以從右上角的「草稿」找回來,素材已經失效的就現場隨便拍一下重新載入,再點一次一鍵成片。
他先講了為什麼推薦快剪快播這一款。第一,它全部免費。這是大疆出的,是空拍機配的剪輯軟體,他們真正賺錢的是空拍機,所以這個軟體幾乎就是送的。第二,它的一鍵成片是他目前用過最好用的。厲害的不是很細的剪輯,而是自動選擇都還蠻準的,幾乎七八成都能選到重點,很適合新手。
介面上最有感的第一個是換音樂,中間那一排點進去就是整個換風格,想要慢版就從這邊調。模板是整個風格所以比較受限,想練習自己調的話他建議先從「簡約」的模板開始,因為比較素、效果比較少,改起來比較好改。
文字跟貼紙的部分,「添加文字」就是加大標小標,可以選字體。打完字之後要選這段字出現在哪裡、要多長:剛好在這裡就是第一個畫面出現的時候有,到第二個畫面就沒有了;也可以往後拉,讓後面幾個畫面都有字。
如果是要上字幕,他說就不推薦用這一款了,推薦美圖秀秀或剪映。剪映口述會直接生成字幕,他說下一堂課可能可以用剪映示範自動生成字幕。他也提到現在所有的手機剪輯軟體介面都長得差不多,大功能都一樣,只是細節的小功能不同。
他中間插了一個提醒:要退出的時候記得按「保存並且退出」,直接返回就沒有了,所以三不五時記得存一下。
音樂這邊有兩個東西。一個是原聲音量:今天拍的只要畫面不要聲音,所以原聲音量是關掉的;但有些場合原聲要留,像等一下要拍自我介紹,原聲音量就要保留。配樂本身可以拉小聲一點。
另一個是淡入跟淡出,他說這個能增加質感。淡入不見得需要,但淡出比較重要。他現場放了兩次給大家比較:沒有淡出就是直接卡掉,有淡出就是慢慢地收尾。他建議最後畫面拍一個大合照、拜拜,音樂慢慢收尾,整支片會好很多。
有學員問能不能選自己的音樂。「音樂庫」是內建的音樂;另一個是「提取音樂」,但這個介面沒辦法直接載入音樂檔,只能從影片裡面截取音樂。所以如果要搭配 Suno,得先下載 Suno 生成的影片到手機,再從影片去截取。
他說手機剪輯本來就有很多限制,最大的問題是手機不太支援檔案下載跟檔案管理,下載 PNG 或 MP4 常常下載完發現不在相簿,很麻煩。所以今天手機這邊他直接跳過配樂的部分,那件事需要桌機剪輯才好做。去年有會桌機剪輯的同學,就可以 AI 生成完之後到桌機那邊去截取音樂。
他也給大家看了桌面版剪輯的實際工作環境:他在家剪輯大概要三個螢幕才夠,一個素材庫、一個時間軸、一個放廠商要求的溝通內容;一天認真拍下來大概幾百幾千個片段,軌道疊個十幾層是很正常的事。想要細部控制,他一律推薦用電腦版。
至於現在該學哪一款,他的建議是如果現在開始要學剪片,他推薦學教 AI 剪片。因為自己學剪映大概要花三四個月,學會之後會發現 AI 都會了,而 AI 進入這個領域差不多才兩三個月。真的要學剪片,他推薦買個筆電然後叫 AI 去剪。
LightCut 裡面有現成的音樂可以選。如果你想要一首別人沒有的,可以用 Suno 生。
LightCut 音樂庫直接挑一首,三十秒搞定。要發社群建議用內建的,版權比較單純。
江昱德補充了為什麼配樂要先用 Suno 把歌詞弄出來,而不是讓 AI 一次自動生成。
原因是歌詞先弄好,我們再照著歌詞去拍會比較好。如果全部讓 AI 自動生成音樂,它可能生成出我們很難拍的腳本。先照自己的想法把歌詞生出來,就比較可控、比較好拍片。
他還多推一步:一開始生成歌詞的時候,就可以把後續的分鏡腳本都想好。
他也給大家看了一個組合應用:他幫一位老朋友寫了一篇有配圖的文章,直接叫 AI 把 PDF 轉成翻頁電子書的模式,另外再用 Suno 把它做成歌,兩個合在一起就可以一邊聽歌一邊看。他說這個需要搭配桌面版的 ChatGPT 一起做。
他順便講了這套做法可以長成什麼樣子:如果是一整天的走讀活動,早上找導覽單位導覽、拍照片、講解,數位能力比較好的還可以把它做成走讀的音樂,最後幫主辦單位做成整場的成果報告,每一個學員都做一份。他說這是 AI 時代很方便的做法,可以認真去用。
這兩個都要用電腦套版,我幫大家做。第四堂我們一起弄。
這一天花了很長的篇幅在 NotebookLM,因為它就是「照片變成別的東西」的主力工具。
介面先講清楚:不管手機還是電腦,都是三個欄位:來源、對話、工作室。電腦版是三欄並排,手機版是縮在底下切換,一次只顯示一個欄位。來源是存資料的地方,也就是材料庫;工作室是產出內容的地方。他建議一律先用筆電,因為完全一樣,但筆電會好操作很多。
原理是:把文字、PDF、照片丟上去,之後就可以生成影片摘要、簡報、資訊圖表、心智圖、學習卡。
影片摘要的示範用的是他跟妹妹重溫老遊戲的故事。他說完整版大概會落在 8 到 10 分鐘,覺得太長可以選摘要,一分多鐘。生成的時候記得選繁體中文,可以選風格,還有一欄是寫「AI 主持人應該著重哪些部分」。他當場寫的是:希望有點像在說溫馨有趣的故事,節奏氛圍輕快一點,像在分享一個有趣的故事跟笑話,但結尾可以稍微發人省思,而且交代 AI 只挑一個重點當結尾,不要什麼都講。放出成品之後他問大家有沒有聽到,說這個語音越來越台灣腔了。
他也提醒一個限制:Gemini 這個系列的圖片都不會太準,同一個角色會出現很多個版本跟樣子。
簡報是生成一頁一頁的投影片 PDF。他示範了改成繪本風格的提示詞:一段話配一個圖片、插畫風格一點、有點像兒童閱讀的風格;畫面設計上遠中近景的景別落差要大一點,不要都是同一個景別,畫面可以有張力一點、趣味一點,但最後收尾溫馨一點。他說現在做繪本很簡單,故事想好丟給它就出來了,這也是成果發表的形式之一。他還提到現在可以只改單個頁面,以前不行,要全部重新生成。
簡報的提示詞怎麼寫,他讓大家自己練。要交代的是:指令、目標對象(給大人看、給小孩看、給自己看)、風格樣式、配色、要不要小插圖,以及這份簡報想給誰看、看完會有什麼感覺。他自己示範的版本是粉嫩少女風格的配色,但字體跟用字要專業一點,因為他覺得一切都是重新的開始、重新的學習,要充滿好奇心像當初的孩子一樣,但內容是真的很認真要蛻變、要學專業的。另一位學員的版本則是女性幹練、企業主老闆那種專業商業簡報的感覺。
他也給了一個控制頁數的訣竅:最好的方法是自己先把文章整理成 12 個段落,提示詞直接說「依照段落生成 12 張簡報」。不要提示詞說要 12 張,段落裡卻有 20 個,那樣 AI 只能自己去配,配不好你又不開心。
資訊圖表他說 NotebookLM 一開始爆紅就是因為這個,網路上看到那種一頁講得很清楚的圖表,基本上就是它做的。他當場換了一版提示詞,要求畫面溫馨可愛、顏色繽紛,但繽紛不要喧賓奪主,所有圖案、插畫風格、顏色線條都要能凸顯課程特色跟學員感想。他看成果的評語是現在的字基本上都正確了,三四個月前很容易錯字。他說要做課程心得回饋都可以做一張這樣的圖,額度會多很多,只是圖片沒辦法那麼豐富。
用真實照片做簡報他講了檔名對應的技巧,用的是他太太爬百岳的故事。因為 AI 不會自己去對,所以他把每一張照片改好檔名丟進去,文章裡也寫清楚:講到這一段的時候請配品田山的照片、講到這一段配那棵樹的照片、講到這一段配登頂的照片、收尾配收帳篷的照片。
然後生成簡報的時候他下的指令是:請幫我用裡面真實的照片去排版,不要自己隨便亂生成圖片;如果真的要生成,也要生成插畫跟示意圖。他說沒有講這些,AI 會參考你的照片模擬生成,成品就變得又不是真實又不是 AI,很詭異;而且遊記有實際的景點,人家一看就會說你這是 AI 生成、你根本沒有真的去。有學員問影片可不可以,他說照片可以、影片不行,AI 不曉得要剪哪一個畫面,太麻煩,不如自己截圖截好。他也補了一句,NotebookLM 嚴格來說是筆記軟體,不是剪輯軟體,他只是把它當這個用。
他還講了一個延伸玩法:把自己的日記丟進去,讓 AI 分析你。他把一大堆日記跟教案丟進去,叫它介紹江江老師是怎麼上攝影課的,他說那時候整個雞皮疙瘩,第一次體會到別人原來是這樣看我上課。他示範的提示詞是請 AI 用旁觀的主持人角度、銳利一點、不用刻意諂媚,深度分析他怎麼教 AI 跟知識管理、有什麼特色、有什麼盲點,要讓學員甚至他本人聽了有醍醐灌頂、一針見血的感覺。他強烈建議大家回家自己玩一次,聽人家這樣分析自己,第一次聽會有很微妙的感覺。
最後他也講了 NotebookLM 比較正規的用法,就是資料檢索。可以把幾十份文件、論文、教材一次丟進去,直接叫它從裡面找資料、生成心智圖、做學習卡、甚至用辯論會的角度講正反方意見。YouTube 連結貼進去轉逐字稿速度超快,他說某些時候他會把它當成轉逐字稿的神器,中文也很快,缺點是沒辦法分講者,兩三個人談話會全部混在一起。
他特別點出這個功能最厲害的地方:你問它問題,它會從資料裡面找,而且每一段都附上來源,很明確告訴你這句話是從哪裡出來的,所以不用擔心它亂回答,非常適合需要精準的時候用。
關於「有真實照片就用真實照片」,他講了一個前幾天的親身觀察。他去參加一個活動,有商會拿到別人送的 AI 年度宣傳片,裡面大概只有四分之一是真實做服務、做公益的現場照片,其他四分之三都是 AI 生成的很華麗的畫面。
他看完覺得很可惜:畫面裡全部都是 AI 生成,連志工可能都是 AI 生成的,明明做了一年的志工那麼地辛苦。他也提到自己的錯誤範例,之前生成過一個滿天星空的版本,用手機拍要拍這麼好,人家一看就知道不是真的。
所以他的建議很明確:有真實的照片就用真實的照片,AI 生成的側圖就當插畫,讓大家一看就知道哪些是 AI 生成的示意圖、哪些是我真實的照片。
今天沒剪完的,回家補完。有一支完整的就好。
從你手機裡挑十張想留下來的,下週做電子相簿要用。
這些照片如果只能配一句話,你想說什麼。
把今天剪好的片傳給家人或朋友,看看他們說什麼。
下次是最後一堂,江昱德把成果發表的最低要求先講清楚了。
最低要求是一張個人的自我介紹頁面,內容就是「我是誰」加上「這是我的成果」。第一天沒上課的同學請自己去看第一天的簡報,自己想辦法生出來。他說大家有作業交出來,他就可以幫大家做頁面。
交的形式他給了幾種:傳 PDF、傳手機隨手拍的短片、把上課的心得寫成一張資訊圖表。也可以是自己出去玩的素材,他舉例上次有一個人拍了打高爾夫的影片,把高爾夫的心得剪出來。
他也有想到會害羞的人:覺得私人素材會害羞,那就分享上課的學習內容;如果覺得剪上課的學習內容很難(他說他自己也覺得很難),那最簡單的做法就是用 NotebookLM 把學習心得做成一張圖表、一份簡報,或者一支第一人稱講自己學到什麼的影片。他建議可以拍幾張上課的花絮跟照片備著,下次一起做。
明天要帶的東西:筆電、360 相機,他自己帶自拍桿。
他預告下次要玩的是輕功轉場,並且當場把做法整個拆給大家看。這個效果是 360 相機加 AI 生成加首尾幀三件事湊起來的:360 相機會自動把自拍桿抹除;先拍一段在天橋底下跑、準備往上跳的畫面,跳起來那一瞬間卡掉,再拍一段已經在天橋上的畫面。
接下來的關鍵是把第一段最後一個畫面截成一張圖、第二段開頭截成一張圖,叫 AI 把這兩張圖接起來,生成中間那一段,看起來就是輕功起飛接過去。他說提示詞超簡單,因為場景在照片裡都有了,不用描述白色的圍欄那些,AI 知道前面長怎樣、後面長怎樣,只要知道中間怎麼樣就好。他實際只描述了「我要有一個非常流暢的起跳,像輕功一樣,然後跳到裡面」,還特別區分不是運動員跑步那種跳躍感,是武俠輕功輕輕點一下往上跳。首尾幀要給的是靜態的圖片。
他也順帶講了 AI 生成影片的正確順序:先生成圖片,再用圖片生成影片。因為只給文字生影片有很多不確定性,要等十幾二十分鐘,等這麼久生出來的又不是想要的。先用文字生成圖片,造型確定 OK 了再用圖生圖、再叫它生成影片。他說這其實就是看圖說故事:第一張圖長怎樣、第二張圖長怎樣,也可以直接給它兩張圖叫它自己合起來,這樣會比較準確。
接著他放了 Will Smith 吃拉麵的對照影片。因為這個太有名了,後來就變成大家拿來測試 AI 生成影片的標準。2023 年那版大家笑爆了,覺得怎麼這麼爛;2026 年那版出來,大家就笑不太出來了。他的觀察是 2025 年就已經很像真人拍的,只是動作比較大的時候物理規律還不對;2026 年是 AI 已經知道物理規律了,潑水、球掉在地上看起來都跟真的一樣,還是有小破綻,但那個破綻要慢放放大看才會發現。
另一個對照是影視颶風,大陸非常有名的實拍創作者,最近在測 AI 生成的效果。他們說一個畫面生成之後大概要花一萬塊人民幣,換算台幣大概四萬五千塊。他們拋出的問題是:如果你有這筆錢,你會叫 AI 生成一個畫面,還是去買相機?一萬塊人民幣可以抽 100 次抽到一個很好的畫面,但去買相機好像可以拍超過 100 個畫面,所以 2025 年大家會覺得買相機比較划算。
但 2026 年他們的答案變了:這個畫面如果要用電影實拍,大概要 10 萬塊,所以就算你買一萬塊的相機,你也拍不出這樣的畫面。江昱德說很有趣的是,今年這個非常有名的實拍團隊願意用這個模式去拍。
他還講了那個團隊 2023、2024 年的一個公益專案:他們想用特效合成,讓一位因車禍不能行走的人可以自由自在地奔跑,燒了很多錢、做了兩年做不出來就停了,後來遇到 AI,用 AI 生成就有了。他說那個團隊的心態非常複雜:第一,非常感謝有 AI 讓這個公益專案可以做完;第二是,他們花了兩年做了那麼多,AI 一出來突然覺得這兩年很沒有意義。2024 年他們還覺得自己再多做一點,2025 年再看一次就覺得有點難過。
他也提醒現在生成很貴:他想像的那個畫面估計要兩三千塊,所以他只會用付費的 Gemini 做,一段就好。
最後他講了一段平台商業模式的變化。YouTube 分廣告收入的門檻改得超高;Meta 商家以前可以隨便放連結,現在免費帳號一個月只能貼兩次,要多發就要付錢。他的解釋是:以前是使用者花時間不花錢,由廣告商付錢;但現在網路上 AI 會比人類多,而 AI 不會看廣告,所以以後不會有廣告付費這件事,廣告商不付錢就只剩使用者自己付費,以後上傳一支影片到 YouTube 可能要自己付成本,就像現在租雲端一樣。他後來自己查證補充,Meta 這個好像還沒正式推出、只是放消息,進階版每個月八條連結額度要 50 美元(台幣約 1600),頂級方案無限發要 500 美元(台幣約 16000),基本上是商家才有這個需求。
下次的內容他也預告了:今天拍的自我介紹影片如果做得出來、時間也夠,就帶大家拍一個「輕功水上飄來上課」的畫面,然後把老師的作品跟大家的作品、心得作品一起做統整。
數位培力課程 第四堂
最後一堂。上午學進階剪輯、把作品統整出來,下午成果發表四堂做了什麼,帶過就好。今天不學新工具
五個項目,做得到幾個就做幾個
插在等生成的空檔講,節奏、轉場、字幕
每個人三分鐘,講完老師點評
中午下課前一定要傳完,老師中午要把大家的東西整理起來,下午發表就翻那一份。
個人設定檔、自己寫的提示詞。它現在認識你。
一個故事怎麼拆成一格一格。
構圖、光線、快剪快播、調色、轉場。
把前面三堂的東西變成看得到的作品。
今天用的每一樣東西,前面三堂都摸過了。今天只是把它們接起來。
加一段自我介紹。用 ChatGPT 生圖。
交出來是:一張圖
用 NotebookLM 做。
交出來是:一張圖
把你的照片做成簡報。用 NotebookLM。
交出來是:一份 PDF
用 Suno AI。
交出來是:一首歌
手機拍,快剪快播剪。
交出來是:一支影片
第一項是最低要求,每個人都要有。第三加第四如果都做出來了,老師會幫你合成一份會唱歌的音樂簡報。
上一堂拍的正面側面照就是材料。先上傳一張你的正面照,再貼這段話。
我要做一張自我介紹用的個人風格照。我已經上傳一張自己的正面照片。
請一次問我這三題,不要一題一題問:
一、我想要的場景(例如 海邊夕陽、書房、廚房、山上、咖啡店)
二、我想給人的感覺(例如 溫暖、專業、自在、有活力)
三、我平常最常做的一件事
我答完就直接生圖,不要再追問。
規則:
臉要看得出來是我,不要修到認不出來。
畫面直式,等一下要放進簡報跟網頁。
圖上不要加文字。
生完問我一句:哪裡要調整。
自我介紹那三句,用第一堂寫的個人設定檔請 AI 幫你整理,不用自己從頭寫。
兩步。先把心得寫成一篇文章,再丟進 NotebookLM 變成圖表。
我上了四堂 AI 創作課,要把學習心得寫成一篇 500 字左右的文章,等一下要丟到 NotebookLM 做成資訊圖表。
請一次問我這四題,不要一題一題問:
一、我來上課之前,最不會的是什麼
二、這四堂裡面,哪一件事讓我最有感覺
三、我做出了什麼東西
四、我現在跟四堂課之前最大的差別是什麼
我答完直接寫成一篇 500 字的文章,分成四段,每段有小標題。
規則:
用我說話的口氣,不要堆成語。
我沒說到的事情不要自己編。
請依照這份文章做一張資訊圖表。
分成四塊,對應文章的四個段落。
風格:(寫你要的,例如 溫暖手繪風、專業商務風、日系清爽風)
配色:(例如 米色配深棕、粉色系、藍綠色系)
給誰看:(例如 給我的家人看、給想學 AI 的朋友看)
文字用繁體中文。
NotebookLM 的路徑:來源放文章,工作室選資訊圖表。生成要等一下,先去做別的,回頭再看。
上禮拜挑的十張照片派上用場了。這一項有一個關鍵技巧,做對了成品差很多。
我要用自己的照片做一份生活故事簡報。
請一次問我這四題,不要一題一題問:
一、這組照片是關於什麼(例如 我種的花、去年的旅行、我的孫子、我的手作)
二、大概有幾張,分別是什麼畫面
三、這個故事我想給誰看
四、看完之後我希望對方有什麼感覺
我答完,幫我寫成一篇分段的故事文案,段落數量跟照片張數一樣。
最重要的規則:
每一段開頭要寫「這一段配:(照片檔名)」。
AI 不會自己判斷哪張照片配哪一段,所以要在文案裡先講好。
寫完提醒我:文案要跟照片一起丟進 NotebookLM,
然後跟它說「依照文案的段落生成簡報,一段一張投影片,照片依照文案指定的配」。
關鍵在這裡:哪一段配哪一張照片,要寫在文案裡。AI 不會自己去看照片內容配對,你在文案裡指名,它才放得對。這是用真實照片做簡報最重要的一件事。
先讓 AI 寫歌詞,再丟 Suno 生成。歌詞先寫好,Suno 唱出來才會是你的故事。
我要把我的故事寫成一首歌,等一下要丟到 Suno AI 生成。
請一次問我這三題,不要一題一題問:
一、這首歌是關於什麼
二、我希望它聽起來是什麼感覺(例如 溫暖、輕快、想哭、有力量)
三、有沒有哪一句話是我一定要放進歌裡的
我答完,給我兩樣東西:
第一,歌詞。分成主歌、副歌、主歌、副歌,繁體中文,不要太長。
第二,一行給 Suno 用的風格描述,寫成英文,包含曲風、樂器、速度、女聲或男聲。
規則:
歌詞用我說話的口氣,不要堆成語。
我沒說到的事情不要自己編。
做出第三項的簡報又做出第四項的歌,兩個都交上來,老師幫你做成會唱歌的翻頁電子相簿,一頁配一段歌詞。
每鏡拍兩次,按下錄影先數三秒,結束再等三秒。手機靠著東西。
全部匯入、排順序、修頭尾、配音樂。
短的比長的好。發表時間只有三分鐘。
今天上午老師會再教一段進階的剪法,等一下就用得上。
一張個人風格照,加三句自我介紹。每個人都要有。
一張圖表,或一份故事簡報。挑你比較有材料的那個。
歌跟影片。時間有剩再做,做不完回家做也可以。
做完一項就馬上存進手機。圖長按存相簿、PDF 按下載、歌按下載、影片匯出到相簿。AI 生出來的東西,關掉視窗就可能找不回來。
全部傳到 LINE 群組,但是要照順序。教室裡有一張卡牌,卡牌在誰手上,就輪到誰傳。
從第一組第一個人開始。卡牌在你手上,才輪到你傳。
在群組打一則「○○○ 開始傳」。這是你的開頭。
照片、影片、音樂連結,你有的通通傳。中間不要停。
打一則「○○○ 傳送完畢」,然後把卡牌交給下一個人。
直接把卡牌給下一個人,等第二輪再傳。不用勉強。
卡牌停在桌上,整班就停住了。沒人要用就拿給老師。
傳完才想到還有檔案,先不要補傳,那會插進別人的段落裡。
最重要的一條。你先傳,後面每個人的東西都會跟你的混在一起。
為什麼要這樣:二三十個人同時傳,訊息全部交叉在一起,老師分不出哪個檔案是誰的。有開頭有結尾,一個人一段,老師才收得乾淨。
上禮拜學的是「怎麼剪」。今天講的是「什麼時候剪」。同樣五個鏡頭,切點差半秒,看起來就是兩支不同的片。
跟著音樂的重拍換鏡頭。一個鏡頭三秒上下,超過五秒看的人會想滑走。人走到一半、東西落地那一瞬間切,兩個鏡頭會接得像同一個動作。
大部分時候直接切最自然。換時間換地點用疊化。一段結束用黑場,整支最多一兩次。花俏的幾乎不用。
自動生成後人工校名字地名。一行不超過十五個字。有人講話時背景音樂壓到兩三成。
轉場的判斷方法很簡單:你如果看得到轉場,那個轉場就太多了。
一句話講完。「這是我孫子第一次去海邊。」
家人、朋友,或是想讓不認識的人看見你。
哪裡卡住、哪裡意外順利、哪裡跟你想的不一樣。
不用講技術,不用講你用了哪個 App。講你的東西就好。講完老師會給你一段點評:這件作品最有力的地方在哪,加一個可以再往前的方向。
個人設定檔、一張自己的形象照
一組輪播圖文卡、分鏡的概念
一支自己拍、自己剪的小影片
五項作品、一個屬於你的網頁
一開始很多人說「我不會用電腦」。四堂課之後,你手上有一個可以傳給家人看的網址。
你有新的經驗、新的想法,就跟 AI 說一聲,讓它更認識你。
做一份故事簡報。一年就有十二份,那是你的生活紀錄。
想好要拍什麼再出門,回來剪的時候會輕鬆很多。
工具會一直換,但「先想清楚要給誰看」這件事不會變。這是這四堂真正想教的。
個人設定檔與形象照
圖文卡
小影片與貼文
五項成果與個人網頁
歡迎留言,也歡迎按讚投票。
看大家的成果 ↗每個人有兩票,可以投給兩位不同的學員。