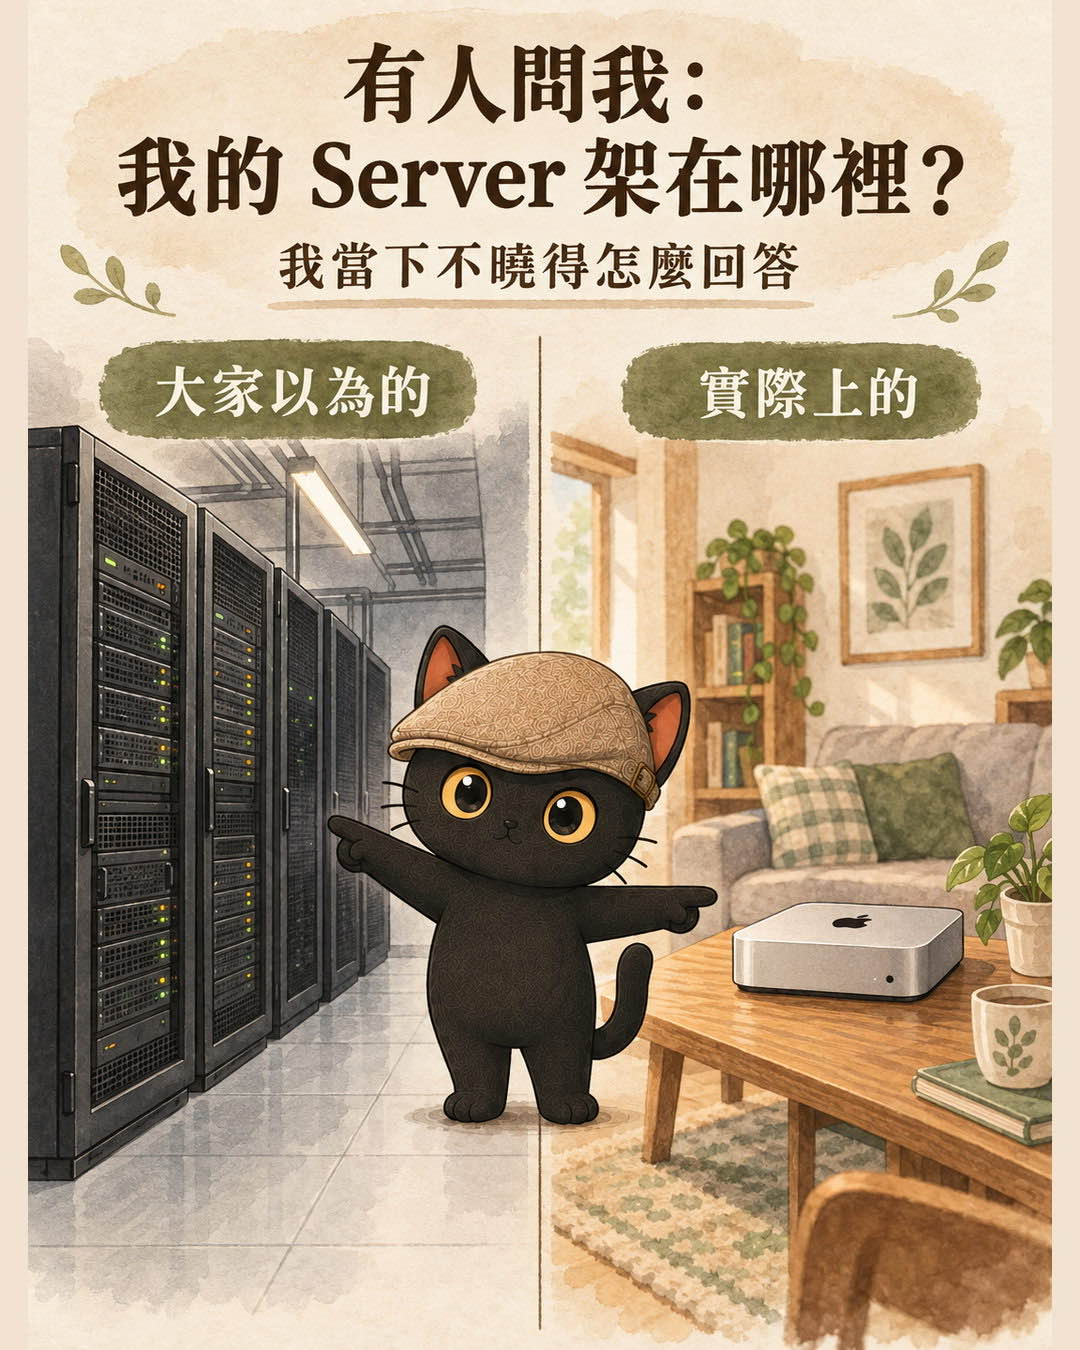
我現在做的是 AI 教學和陪跑。有一天,有人問我:「你的 Server 架在哪裡?」我突然不曉得怎麼回答。對我來說,我一直就是把自己的知識庫建構好,然後讓 AI 來讀就好了,這件事太自然,自然到我從來沒想過要怎麼跟別人描述它。但後來我發現,隨著我做的事情越來越複雜,我的架構確實應該要釐清一次。這一篇就是把三件事講清楚:我的知識庫到底存在哪裡、AI 要怎麼去讀它、我人在外面用手機操作到底是怎麼操作。
中文的「主機」通常指那台實體機器,「伺服器」講的是它扮演的角色,英文都叫 Server。搞混的人多,是因為大家腦中的畫面不一樣,不是因為它們真的是三種東西。
- 被人問過「你的 Server/主機架在哪」,當下答得零零落落的人。
- 常聽到主機、伺服器、雲端、本機這些詞,但從來沒搞清楚它們的關係。
- 想知道「手機連回家裡那台電腦」到底有什麼好處的人。
- 一組三句話的判準,任何一台機器丟進去就知道它算不算 Server。
- 一張四層地圖,看得出指令、檔案、模型、執行各自站在哪一層。
- 四個可以直接複製的回答版本:完整版、電梯版、對客戶版、對不懂技術的朋友版。
為什麼「你的 Server 在哪」這個問題這麼容易答錯
當有人問「你有沒有自己的 AI Server」,腦中浮現的畫面通常是機房裡那種黑色鐵櫃,幾十顆風扇一起吹,燈號閃個不停。
然後你看看客廳桌上那台安安靜靜、跟便當盒差不多大的 Mac mini,直覺反應會是:「應該沒有吧。」
但如果換一個問法:「你有沒有一台機器,長時間開著、隨時待命,幫你跑自動化、幫你存取檔案、幫你執行 AI 代理人的工作?」
答案會突然變成:「有啊,就在我家。」
同一件事,兩種答案。問題出在我們對「Server」這個詞的想像被機房綁架了。
而且這個問題還有第二層麻煩。我手上其實有兩套架構,不是一套。
一套是我自己每天在用的完整 AI 工作流。它必須連到我家的機器、碰得到我的檔案,所以是本機加雲端的混合式架構。
另一套是我做給客戶的小型獨立專案。它交付出去就要自己活,所以盡量做成全雲端架構。
這兩套的設計邏輯正好相反。混在一起講,就是各種誤會的來源。
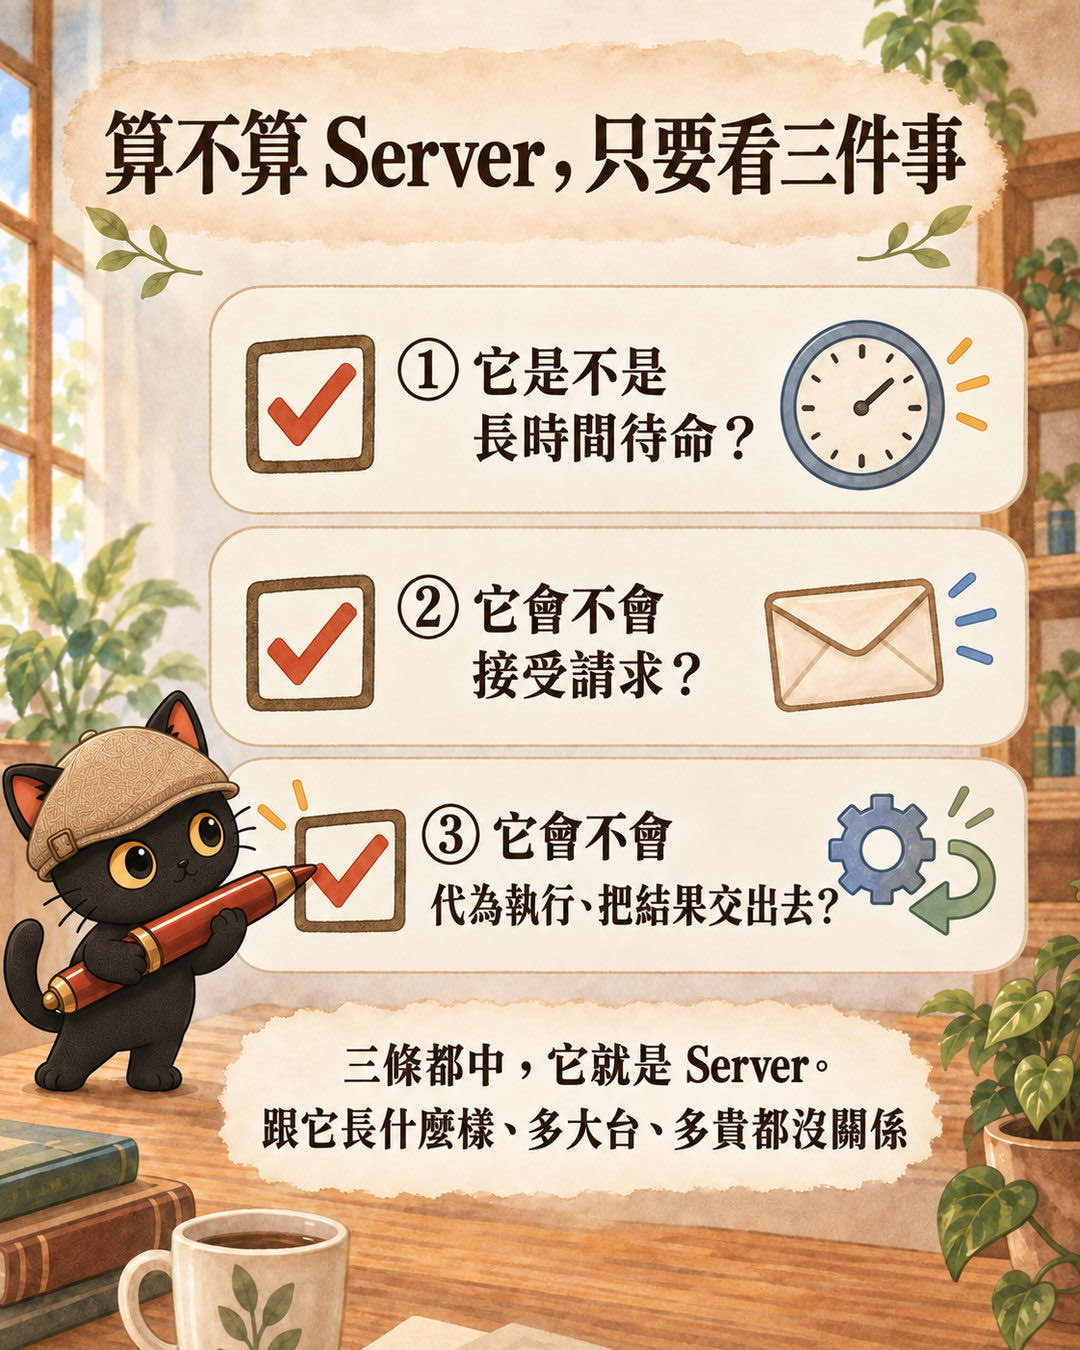
判斷一台機器是不是 Server,只要看三件事
「Server」翻成中文是「伺服器」,但這個詞真正的意思接近「服務生」。重點在於它在整個系統裡扮演什麼角色,跟它長什麼樣子、多大台、多貴都沒有關係。
Server 的核心特徵是「你沒在用它的時候,它也醒著」。筆電合蓋就睡、關機就斷,那是終端。持續開著等指令進來,那是伺服器。
有人(或有程式、有排程)向它提出要求,它接得到。請求可能來自手機、來自定時任務、來自另一個程式。
收到請求之後,它自己動手做,然後把結果交出去。它不只是被動地把檔案攤在那裡讓別人自己拿。
三點都符合,它就是 Server。鐵櫃、Mac mini、還是一台老筆電,完全不影響這個判定。
這裡順便講一個更違反直覺的事實:一台機器可以同時是 Server,也同時是別的東西。「Server」比較像一頂帽子,不是身分證上的職業欄。同一台機器早上戴這頂、下午戴那頂,甚至同時戴兩頂,都很正常。
我的三個問題,一題一題回答
名詞對齊之後,剩下的就是把我自己這套東西拆開來看。我卡住的其實就是這三個問題,而且它們是有順序的:先有資料,才需要有東西去讀它,最後才是我人不在家的時候怎麼指揮。
第一題:我的知識庫到底存在哪裡?
先給知識庫一個正確的定位。它不只是一堆檔案,它是我所有內容的唯一真相來源(single source of truth)。意思是:當任何地方對同一件事有不同版本,以知識庫裡的為準。它是基準,是原本,是最後拍板的那一份。
它存在我家那台 Mac mini 上。
但這裡有一個關鍵,也是最多人搞混的地方:知識庫地位很高,可是它不是 Server。
用前面那三個判準對一次就知道了。它不會待命,因為它是靜態的。它不會接受請求,因為它不會動。它不會代為執行,因為它只是資料。三條全部不符合。
書架上的書再多、整理得再漂亮、分類再精準,它們也不會在你喊一聲「幫我把去年那份提案找出來」的時候自己飛過來。書是正本,但書不會自己走路。
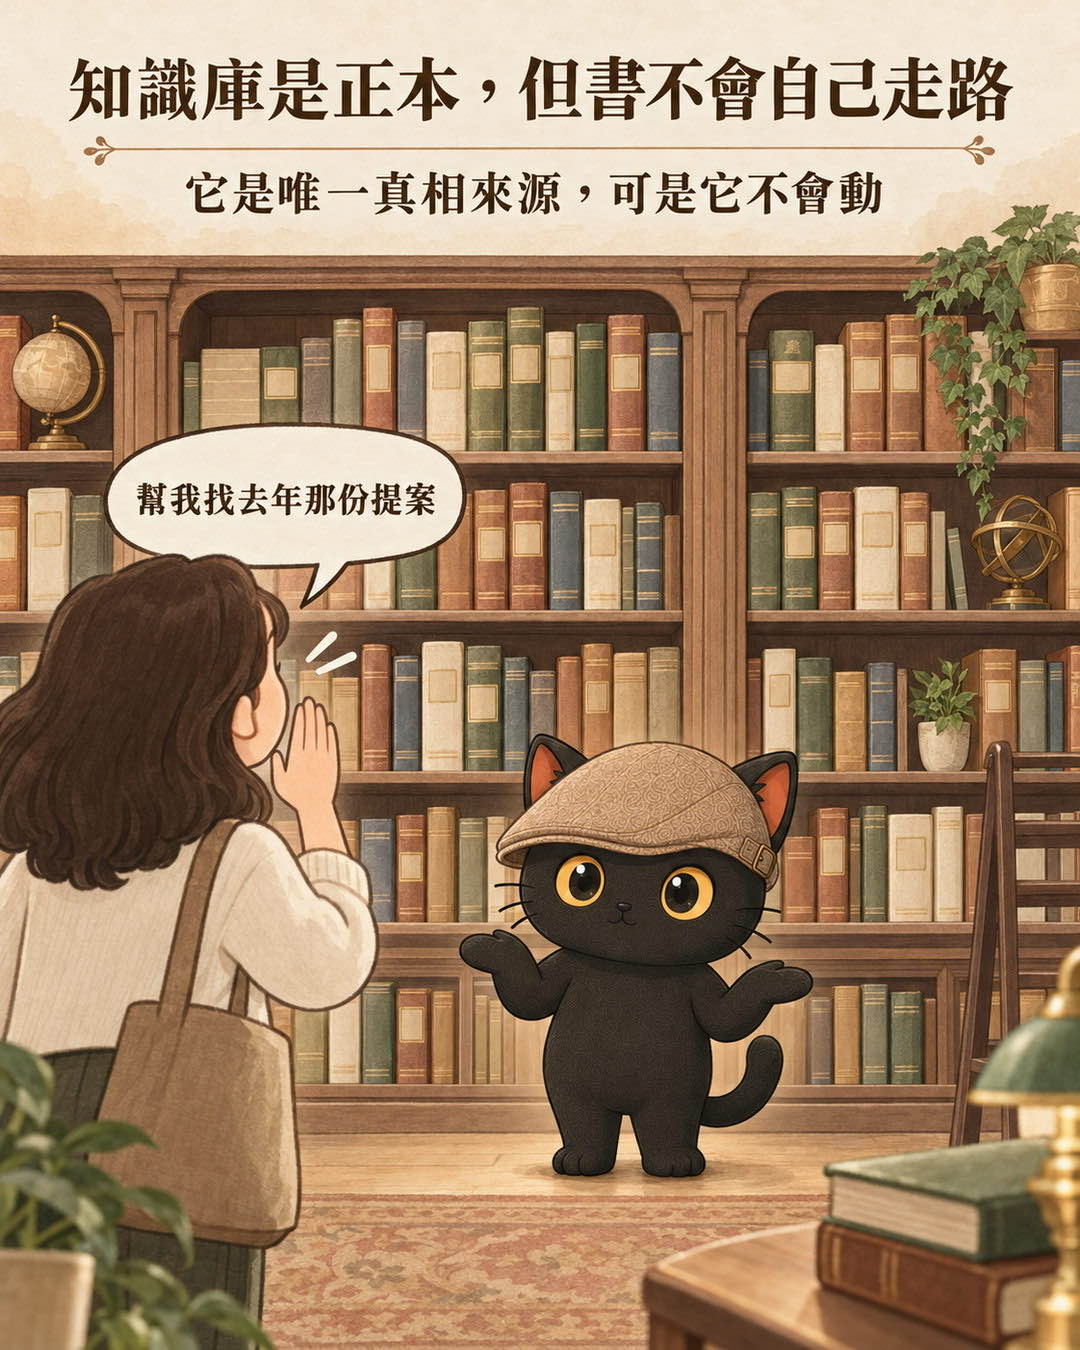
所以一定要有一個東西,去翻它、抽它、把它交到我手上。那個東西是誰,就是第二題。
- 知識庫太大,資料該怎麼分庫?:我改成三庫分流 這篇談知識庫在架構裡站哪個位置,那篇談當它大到一個程度,內部該怎麼切。
第二題:AI 是怎麼讀到我的知識庫的?
答案是:透過一個在我家 Mac mini 上執行的 AI 代理人。
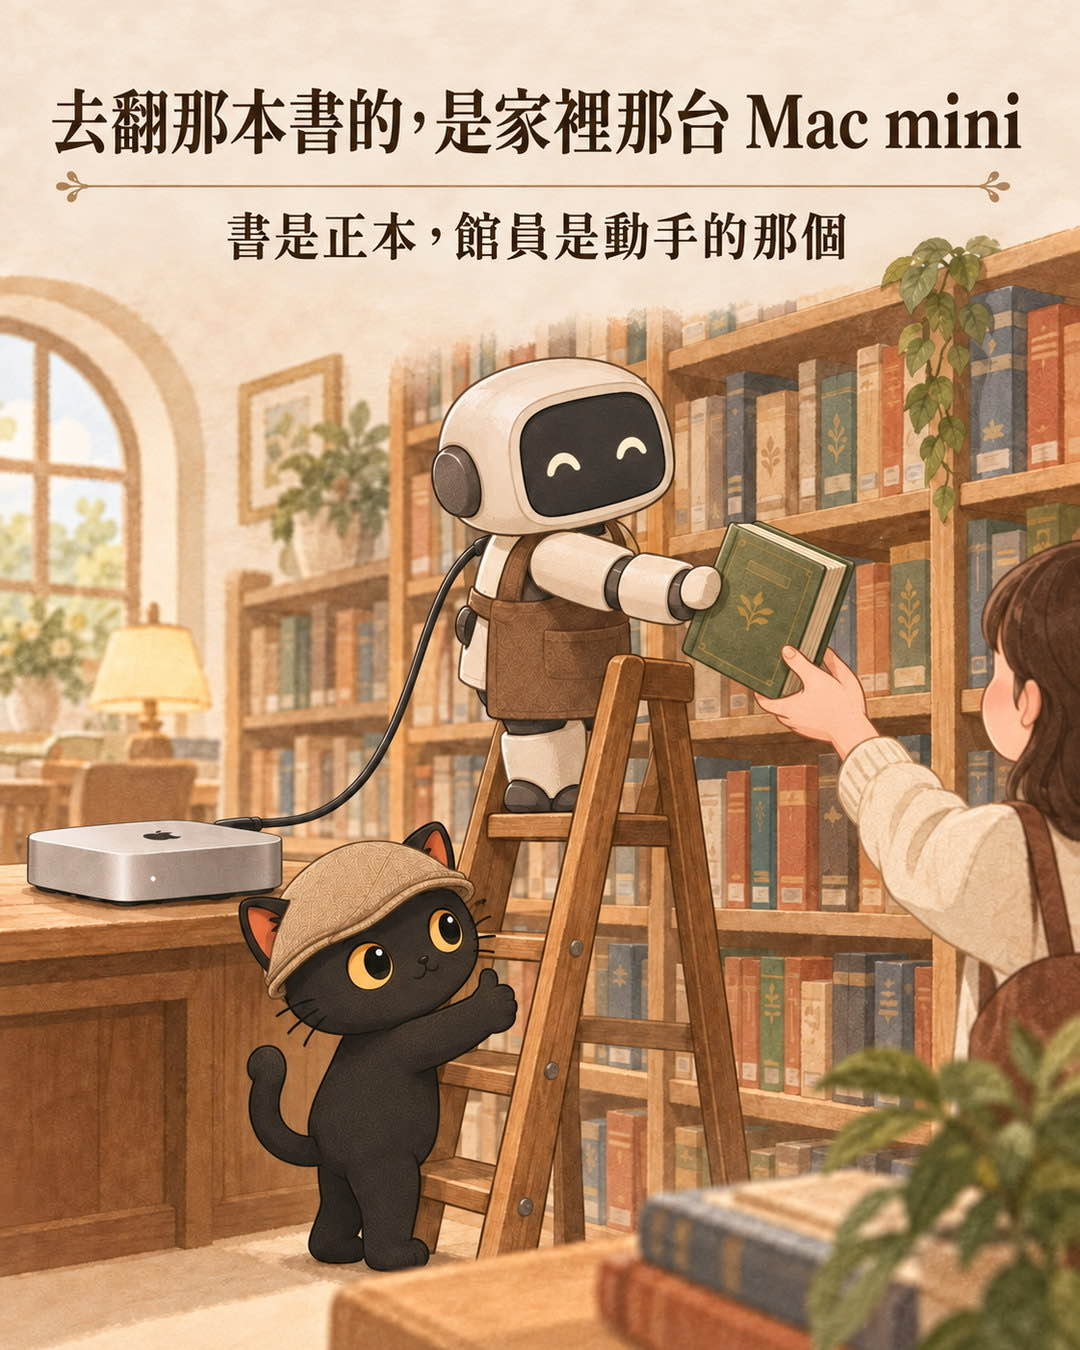
接續上面的比喻:如果知識庫是書,那 Mac mini 上跑的代理人就是館員。是館員走過去、翻索引、抽出那一本、交到你手上。
書是唯一的正本,館員是唯一動手的人。兩個都不可或缺,兩個是不同的東西。
| 知識庫 | Mac mini | |
|---|---|---|
| 是什麼 | 資料層/內容來源 | 執行層/工作中樞 |
| 地位 | 所有內容的唯一真相來源 | 唯一碰得到本機檔案與工具的節點 |
| 會不會待命 | 不會,它是靜態的 | 會,它長時間運行 |
| 會不會執行 | 不會 | 會 |
| 可以搬走嗎 | 可以,它是資料 | 換一台機器就得重建環境 |
之所以容易搞混,是因為我從來沒有直接接觸過知識庫。我都是透過對話拿到裡面的內容,中間那一層太順了,順到我感覺不到它的存在,於是就把兩者當成同一件事。
一句話記住:知識庫是正本,Mac mini 是動手的人。倉庫跟店員是兩回事。
那台 Mac mini,就是我的本機工作中樞
把前面三個判準套到它身上:
- 長時間運行,符合「待命」。
- 讓代理人執行本機工具、跑自動化,這就是「接受請求、代為執行」。
- 讀取檔案、存取知識庫,這是最經典的伺服器職務之一,檔案服務。
三條全中。所以答案很清楚:我家的 Mac mini 就是一台家用伺服器。
而且它還戴了第二頂帽子。當它跑代理人、跑自動化流程時,它在實際執行工作,開檔案、跑指令、動手改東西。這個角色更接近「工作站」。
「中樞」點出了它在我這套工作流裡的位置:要動到我本機檔案的事情,都得從它身上經過。我下的指令從它進來,我的檔案由它讀取,雲端的模型由它去呼叫,做完的結果由它寫回去。
它不一定是最聰明的那個環節,但它是唯一同時碰得到我的檔案、我的工具、和外部服務的那個環節。抽掉它,整套工作流就斷了。
模型在雲端,那實際動手的是誰?
這是第二題裡最關鍵的一層,因為它解釋了為什麼我這套一定要「混合」。
Codex、Claude Code 這類工具,本身是跑在我電腦上的程式,但它們真正的「腦」(大模型)在雲端。它們會透過在我家 Mac mini 上執行的代理人,去存取本機資料、完成工作。
「腦」負責理解我的指令、判斷該做什麼、寫出內容與程式碼。這需要巨大的算力,所以在雲端。「手」負責真的去開那個檔案、真的去跑那個指令、真的把結果寫回知識庫。這需要碰得到我的東西,所以必須在 Mac mini 上。
再換一個比喻:這像是一位遠端的專業顧問,搭配一位在你家現場的助理。
顧問經驗豐富、腦子很好,但他人在國外,摸不到你家的檔案櫃。助理不負責出主意,但他站在你家客廳,開得了櫃子、拿得到資料、動得了手。顧問說「幫我把第三層那份合約拿出來、改這幾段、存回原位」,助理照做。
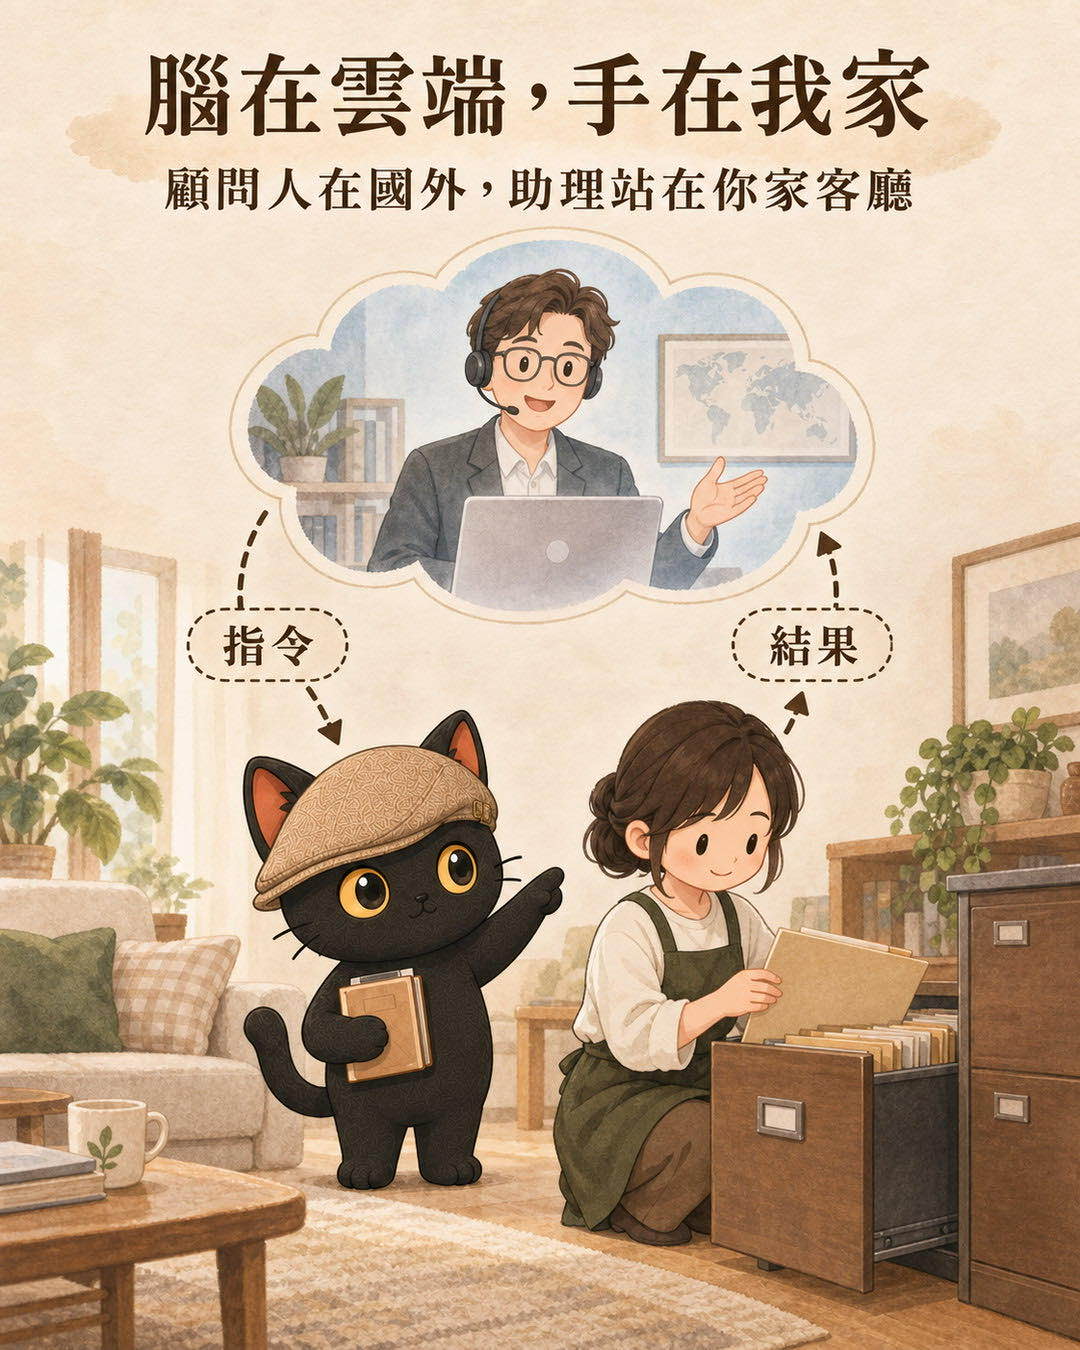
這個分工帶出一個很重要的結論:「用雲端模型」和「工作在本機發生」是同一件事的兩半,它們沒有衝突。
所以那些常見的說法,都只講對一半:
- ✗「我的 AI 都在雲端跑。」那我家 Mac mini 上實際執行的檔案操作、自動化、本機工具呼叫,全都被抹掉了。
- ✗「我的 AI 都在本機跑。」那大模型的運算能力是哪裡來的?
- ✓「模型能力來自雲端,實際動手的代理人跑在我家的 Mac mini 上,資料存在我的知識庫裡。」
這就是混合式架構的完整意思。它不是「一半在這、一半在那」的隨便分配,是照能力分工:算力大的放雲端,碰得到資料的放本機。
- ChatGPT Work、Codex、一般 ChatGPT 怎麼分工?先看電腦、資料與額度 這篇講架構怎麼分層,那篇講在這個架構下具體該選哪個工具。
第三題:我人在外面,用手機是怎麼操作的?
很多人問我的其實是這一題:「你用手機就能叫 AI 做事,那 AI 是不是跑在手機裡?」
不是。我的手機在這套系統裡扮演的是遠端操作端,白話講就是遙控器。我在手機上打字、下指令、看結果,但這些事情實際上都不是在手機裡發生的。
遙控器的比喻很貼切:你按下遙控器上的「音量+」,聲音變大的是電視。沒有人會因為自己手上拿著遙控器,就說「電視在我手上」。
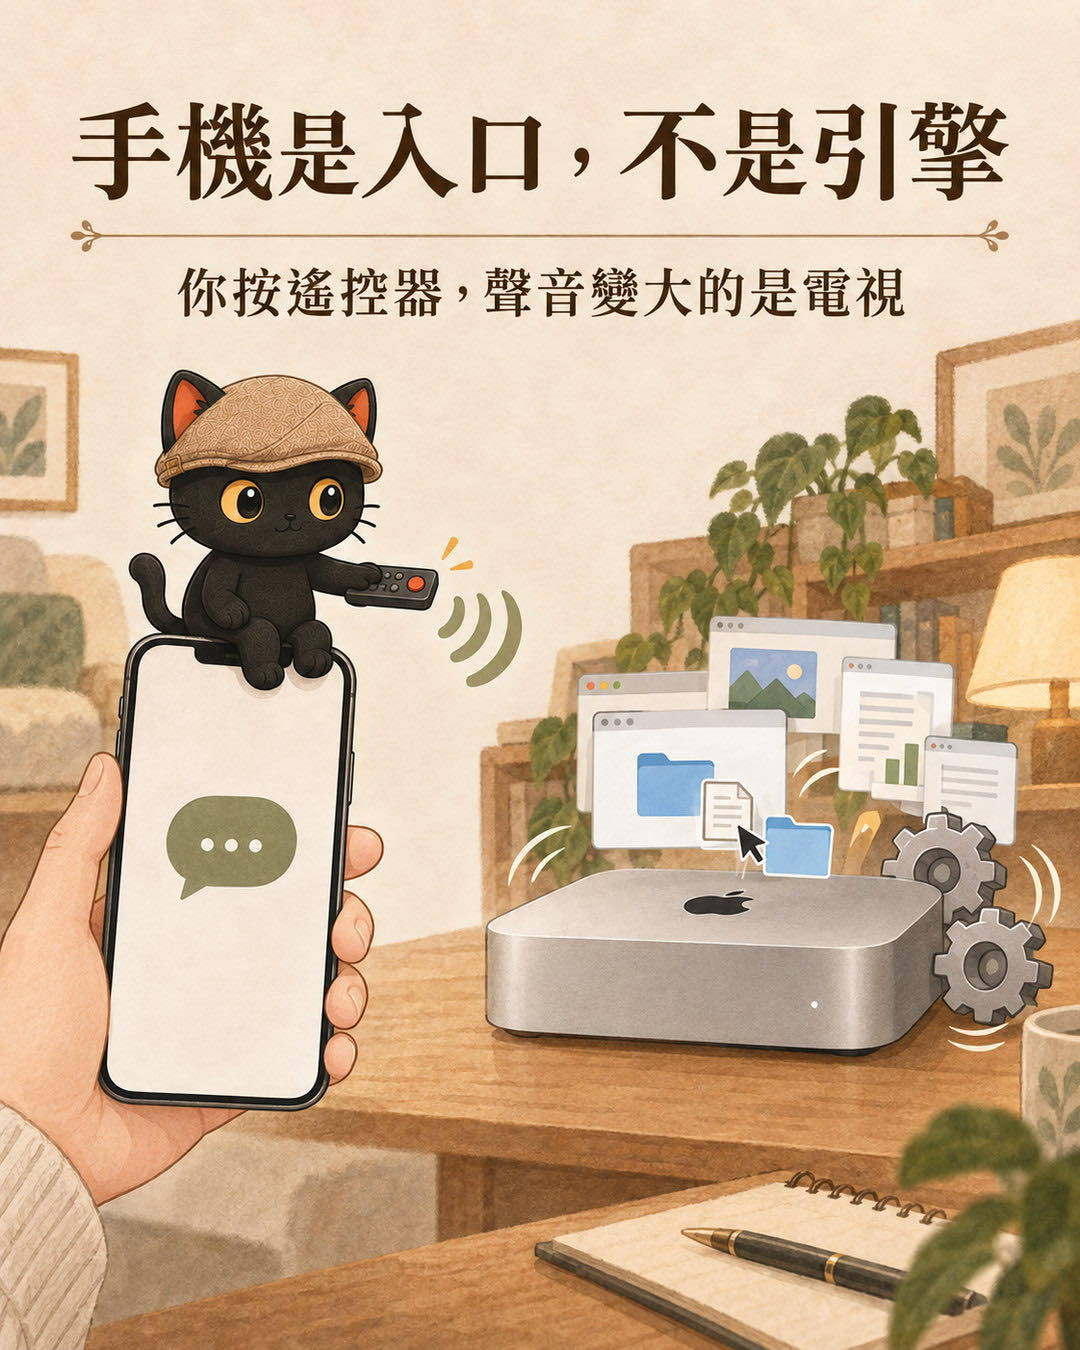
✗「我在手機上叫 AI 幫我整理檔案。」容易被理解成「AI 跑在手機裡」。
✓「我用手機下指令,讓家裡的 Mac mini 幫我整理檔案。」
那手機連回家裡那台機器,好處到底是什麼?
好處來自這個分工本身。
第一,手機不需要很強。運算在雲端、檔案在家裡,手機只負責把我的意思送出去、把結果顯示出來,它不必扛任何重活。
第二,我的工作檔案不必為了「在外面能用」而複製一份到手機。知識庫留在家裡那台,我是去指揮那台機器讀它,不是把它搬過來。少一份副本,就少一次「哪一份才是最新的」的麻煩。
第三,我人不在電腦前,那台機器照樣在動。這是最實際的一點。指令送出去之後,執行的是家裡那台。
至於「手機用什麼方式連回家裡那台機器」,那是另一個題目,牽涉到各人的網路環境與資安設定,做法不只一種。這篇只談角色分工:不管用哪種方式連,手機的位置都一樣,它是入口。
一句話記住:手機是入口,不是引擎。
- 人在外面,可以叫家裡的電腦先做嗎?:手機掃一次 QR code,桌機就開始跑 這篇講手機在架構裡是什麼角色,那篇是同一件事的實際操作版本。
四個角色合起來:一張四層地圖
三題都回答完,整張圖就出來了。
| 層級 | 誰在做 | 做什麼 |
|---|---|---|
| 操作層 | 手機(遠端)/Mac mini 本機 | 我下指令、看結果的地方。人在外面就靠它接續工作 |
| 整合中樞 | Mac mini | AI 工作的環境:代理人在這裡執行本機工具、跑自動化、讀寫檔案、串接雲端 |
| 資料層 | 知識庫 | 所有內容的唯一真相來源 |
| 模型能力層 | 雲端(Codex、Claude Code 等) | 負責判斷:提供大模型的理解、判斷與生成能力 |
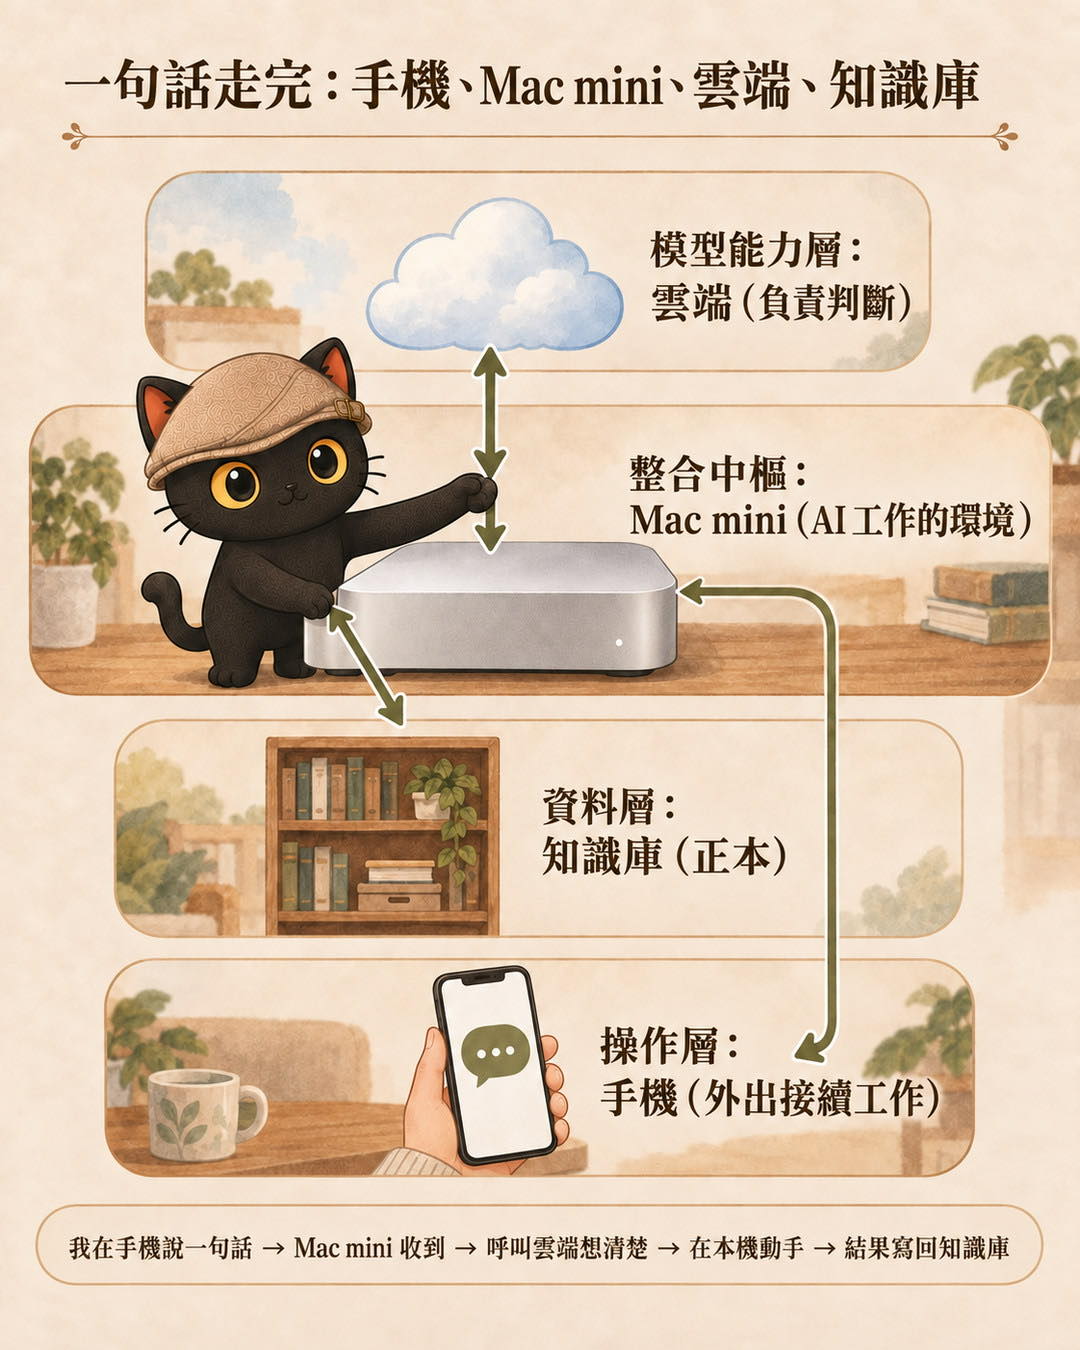
我在手機上說一句話 → Mac mini 上的代理人收到 → 它呼叫雲端的模型想清楚要做什麼 → 它在本機動手做 → 結果寫回知識庫。
Mac mini 站在正中間,是唯一同時連得到上下左右的節點。這就是「本機工作中樞」的意思。
那為什麼這套不能全部搬上雲端?
因為它的目的就是要碰我的檔案。一個碰不到我知識庫的 AI 工作流,對我來說沒有價值。所以本機那一塊是必要的,不是因為懶得搬。
一旦確認知識庫是唯一真相來源,它的備份重要性就跟著跳了一級。這件事本篇不展開,但值得你自己盤一次。
做給客戶的東西,不能綁在我家
前面講的是我自己用的系統。但我還做另一種東西:替客戶製作的小型獨立專案。
這類專案的設計原則跟上面正好相反:能不碰本機就不碰本機,盡量做成全雲端架構。
自己用的工具可以綁在自己家,交給別人用的服務不行。
我自己的工作流斷了,我知道發生什麼事,重開就好。但客戶的服務斷了,是客戶的使用者在現場一臉問號,而且他們不會知道原因是「台北某個人家裡跳電」。
所以標準很簡單:交付出去的東西,必須在我完全不在場的情況下正常運作。
一個交付給客戶的案子,架構長什麼樣
我幫一位講師做過一個香氛卡生成網站,給她工作坊的學員現場用。這個案子的架構是這樣:
- 網站、後端功能、資料儲存,全部放在 Cloudflare(一家雲端服務商,網站與程式可以直接託管在它的機器上)。
- 需要生圖的時候,由 Cloudflare 的後端去呼叫 OpenAI 的圖片生成 API。
- 圖生出來之後,結果存回 Cloudflare。
學員打開網站(Cloudflare)→ 送出需求,後端接手(後端就是使用者看不到、負責實際處理的那一段程式)→ 後端呼叫 OpenAI 圖片生成 API(外部服務)→ 圖回到 Cloudflare → 存回 Cloudflare → 回傳給學員。
看出來了嗎?整條線裡面,沒有任何一個環節經過我家的 Mac mini。
這帶來一個很具體、也很好講的結果:我家跳電,學員端的服務不會停。
這是設計出來的。這個案子從一開始就沒有把任何環節放在家用機器上,所以家裡發生什麼事,跳電、網路斷線、Mac mini 重開機、我出國兩週,學員那端都感覺不到。
這就是全雲端的價值:服務的可用性,跟我本人的狀態脫鉤。
一個必須講對的用詞:是 API,不是「ChatGPT 伺服器」
這一段專門處理一個很常見、但會造成誤解的說法。
正確的講法是:「Cloudflare 的後端呼叫 OpenAI 的圖片生成 API。」不要講成:「我們連到 ChatGPT 的伺服器。」
為什麼要這麼計較?三個理由。
一、ChatGPT 是產品,API 是服務端點。ChatGPT 是給人用的聊天介面,你打開網頁、輸入文字、看回應。這個案子裡沒有任何人在跟 ChatGPT 聊天,是程式對程式,後端送出一個請求,拿回一張圖。那條管道叫 API。
二、「伺服器」這個詞會讓人以為有一台機器是我的。說「連到某某伺服器」,聽起來像是那頭有一台我租的、我管的機器。實際上我只是呼叫一個公開的服務端點,那頭的機器長什麼樣、在哪個機房、有幾台,我完全不需要知道,也管不到。這正是 API 的意義:買的是「能力」,不是「機器」。
三、講錯詞會讓整段架構描述失去可信度。如果我跟客戶說「我們串了 ChatGPT 的伺服器」,稍微懂的人會立刻知道我在用外行話。但我說「後端呼叫 OpenAI 的圖片生成 API,結果存回 Cloudflare」,這句話一聽就知道我清楚自己在做什麼。
用詞精準的目的,是讓對方相信我講的其他部分也是準的。
- 叫 AI 幫你點餐,就懂 CLI、API、MCP 那篇把 API、CLI、MCP 三個詞一次講清楚,這篇只用到其中的 API,想補基礎可以先看那篇。
兩套架構的對照表
這是整篇文章最值得記住的一張表。
| 個人完整工作流 | 客戶小型獨立專案 | |
|---|---|---|
| 架構類型 | 混合式(本機 + 雲端) | 全雲端 |
| 代表案例 | 我的日常 AI 工作流 | 學員用的香氛卡生成網站 |
| 執行中樞在哪 | 家裡的 Mac mini | Cloudflare 上的後端 |
| 資料存在哪 | 知識庫(本機,唯一真相來源) | Cloudflare |
| 模型能力來自 | 雲端(Codex、Claude Code 等) | 雲端(OpenAI 圖片生成 API) |
| 誰在用 | 我自己 | 學員、客戶的使用者 |
| 我家跳電會怎樣 | 我的工作流會中斷 | 服務照常運作,不受影響 |
| 為什麼這樣設計 | 因為它必須碰得到我的檔案 | 因為它必須在我不在場時也能活 |
第一,這兩套架構沒有好壞之分,是目標不同。個人工作流的目標是「能動我的東西」,所以本機那一塊是必需品。客戶專案的目標是「不需要我也能跑」,所以本機那一塊會變成負債。同一個設計決策,在兩個情境下的評價正好相反。
第二,混為一談會造成很具體的誤會。只講個人工作流,客戶可能誤以為「他的網站跑在你家電腦上」,開始擔心你家停電、擔心你哪天不做了。只講客戶專案,對方會以為你「全部都在雲端」,那你 Mac mini 上實際跑的那一半就整個被抹掉了。
所以講的時候,要先分清楚在講哪一套。
三種問法,三種答案
回到最初那個問題。答案取決於對方問的是哪一種。
如果問的是:「你有沒有自建的 GPU 機房、企業級專用 AI 伺服器?」
沒有。這一點我講得很乾脆。我沒有專門為了跑 AI 而蓋的機房,沒有一整排 GPU,沒有企業級的伺服器硬體。這個規模的東西我沒有。承認這件事不吃虧,含糊其辭才吃虧,因為一旦對方追問細節,前面所有的話都會一起失去可信度。
如果問的是:「你有沒有一台自己的機器,長時間跑著,負責 AI 相關的工作?」
有。就是家裡那台 Mac mini。它是我個人工作流的本機工作中樞。
如果問的是:「你做給客戶的東西,跑在哪裡?」
跑在雲端,跟我家那台機器無關。
可以直接照著講的四個版本
我自己的 AI 工作流是混合式架構。家裡有一台 Mac mini 長時間開著,當本機工作中樞,讓 AI 代理人執行本機工具、跑自動化、讀寫我的知識庫,知識庫是我所有內容的唯一真相來源。大模型的能力,像 Codex、Claude Code,來自雲端,但它們是透過跑在 Mac mini 上的代理人來存取我的本機資料、完成工作。
至於我做給客戶的小型專案,會盡量做成全雲端。像我做過的一個香氛卡生成網站,網站、後端跟資料儲存都在 Cloudflare,生圖是由 Cloudflare 後端去呼叫 OpenAI 的圖片生成 API,結果再存回 Cloudflare。這套完全不依賴我家的機器,我家跳電,學員端照樣能用。
所以我沒有自建 GPU 機房,也沒有企業級的專用 AI 伺服器。
我自己用的是混合架構,家裡一台 Mac mini 當本機中樞,模型能力走雲端。客戶的案子則盡量全雲端,不綁我家的機器。
您的服務完全跑在 Cloudflare 上,生圖是呼叫 OpenAI 的 API,跟我個人的設備沒有關係,我這邊斷網斷電都不影響您。
我家那台小電腦一直開著幫我做事,比較重的運算丟給外面。但我幫別人做的網站是放在網路上的,不放我家。
「對客戶講的版本」特別重要,因為它正面回答了客戶心裡那個沒問出口的問題:「這東西會不會哪天因為你而掛掉?」
最後:一句話帶走
Server 講的是角色,跟機器的外型沒有關係。我自己的工作流,腦在雲端、手在家裡那台 Mac mini、正本在知識庫、遙控器在手上。我交出去的客戶專案,則整套住在雲端,跟我家的電源開關無關。
一套為了「碰得到我的東西」,所以必須有本機。一套為了「不需要我也能活」,所以不能有本機。
回頭看,我當初答不出來,不是因為我的架構有問題,是因為我從來沒有把它講成一句話。把知識庫、Mac mini、手機、雲端各自站在哪裡講清楚之後,這個問題就再也不難回答了。
你不需要一個機房,才能說自己有一套系統。你需要的是說得出每個零件站在哪裡、做什麼事、為什麼放在那裡。
- 知識庫太大,資料該怎麼分庫?:我改成三庫分流 看完這篇知道知識庫是正本之後,下一個問題通常是它該怎麼切。
- ChatGPT Work、Codex、一般 ChatGPT 怎麼分工?先看電腦、資料與額度 這篇畫出四層地圖,那篇談每一層具體該放哪個工具。
- 人在外面,可以叫家裡的電腦先做嗎?:手機掃一次 QR code,桌機就開始跑 把「手機是遙控器」這件事,變成一次可以照做的實際流程。
- 叫 AI 幫你點餐,就懂 CLI、API、MCP 這篇只用到 API 一個詞,那篇把三個常混用的詞一次分清楚。
- AI 出錯不可怕,沒有備援才可怕:一次搞壞 170 檔案的教訓 往回補一課:本篇說知識庫是唯一真相來源,那篇講唯一真相來源沒有備份時會發生什麼事。
- AI 時代怎麼整理資料,讓文件變成可用的系統 往前補一課:這篇假設你已經有知識庫,那篇談資料要怎麼整理才變得成知識庫。